业务逻辑漏洞
业务逻辑漏洞
业务逻辑漏洞是应用本身的业务流程设计存在缺陷。
场景:对客户端控件的过信任
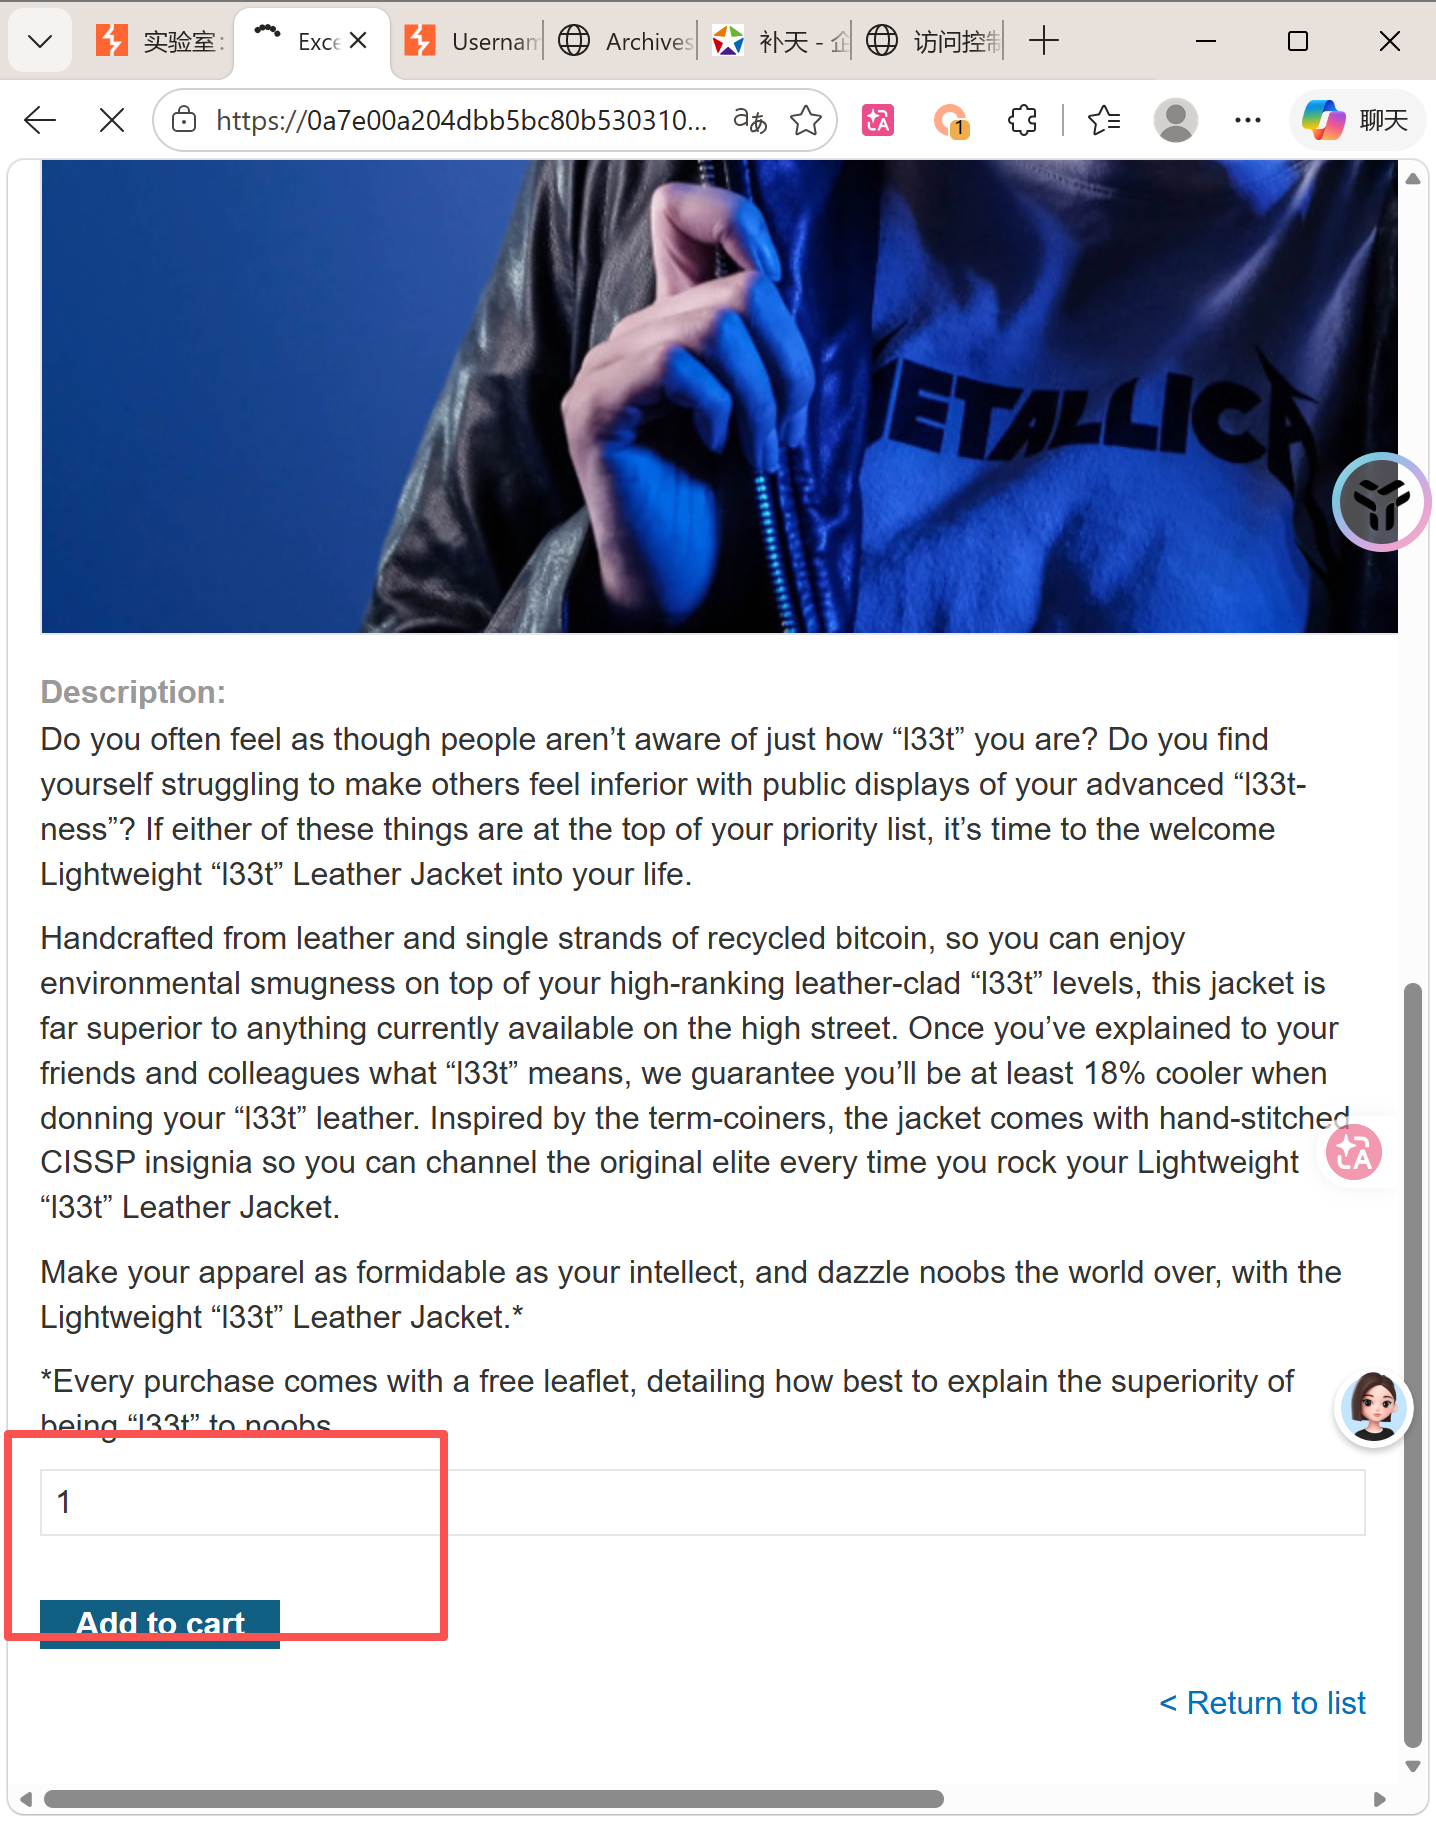
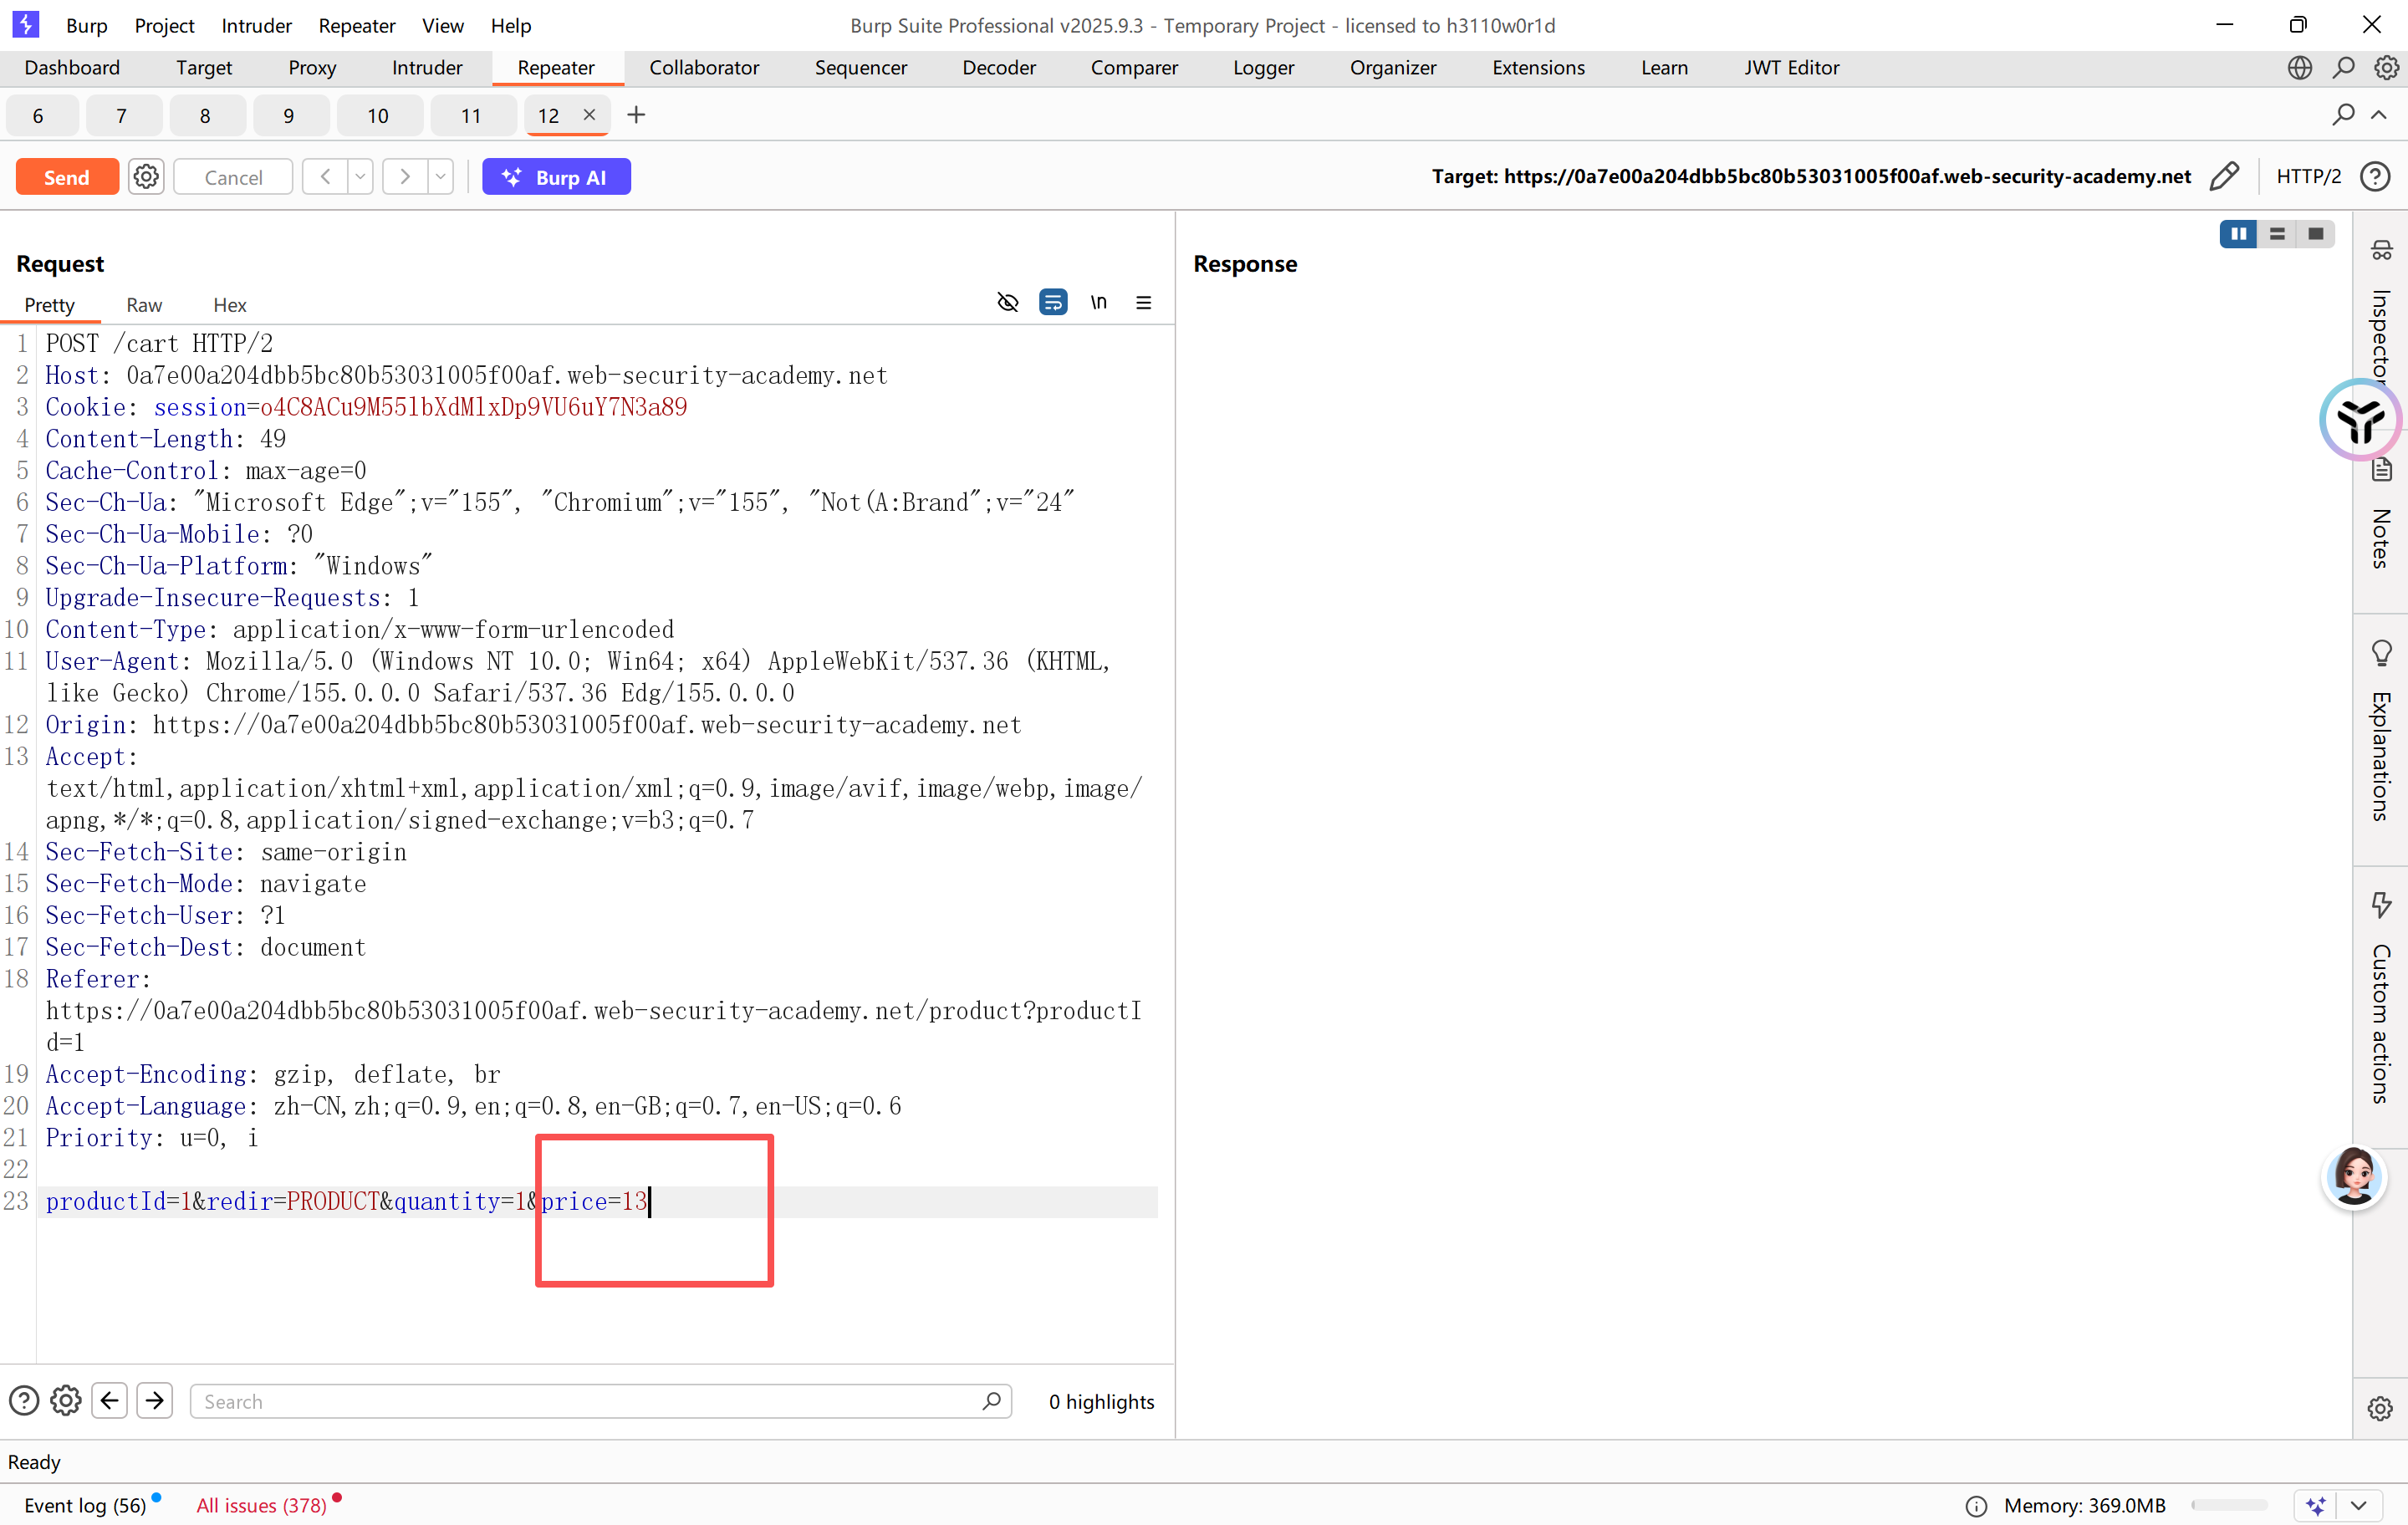
在加入购物车之前把这里的积分数量修改
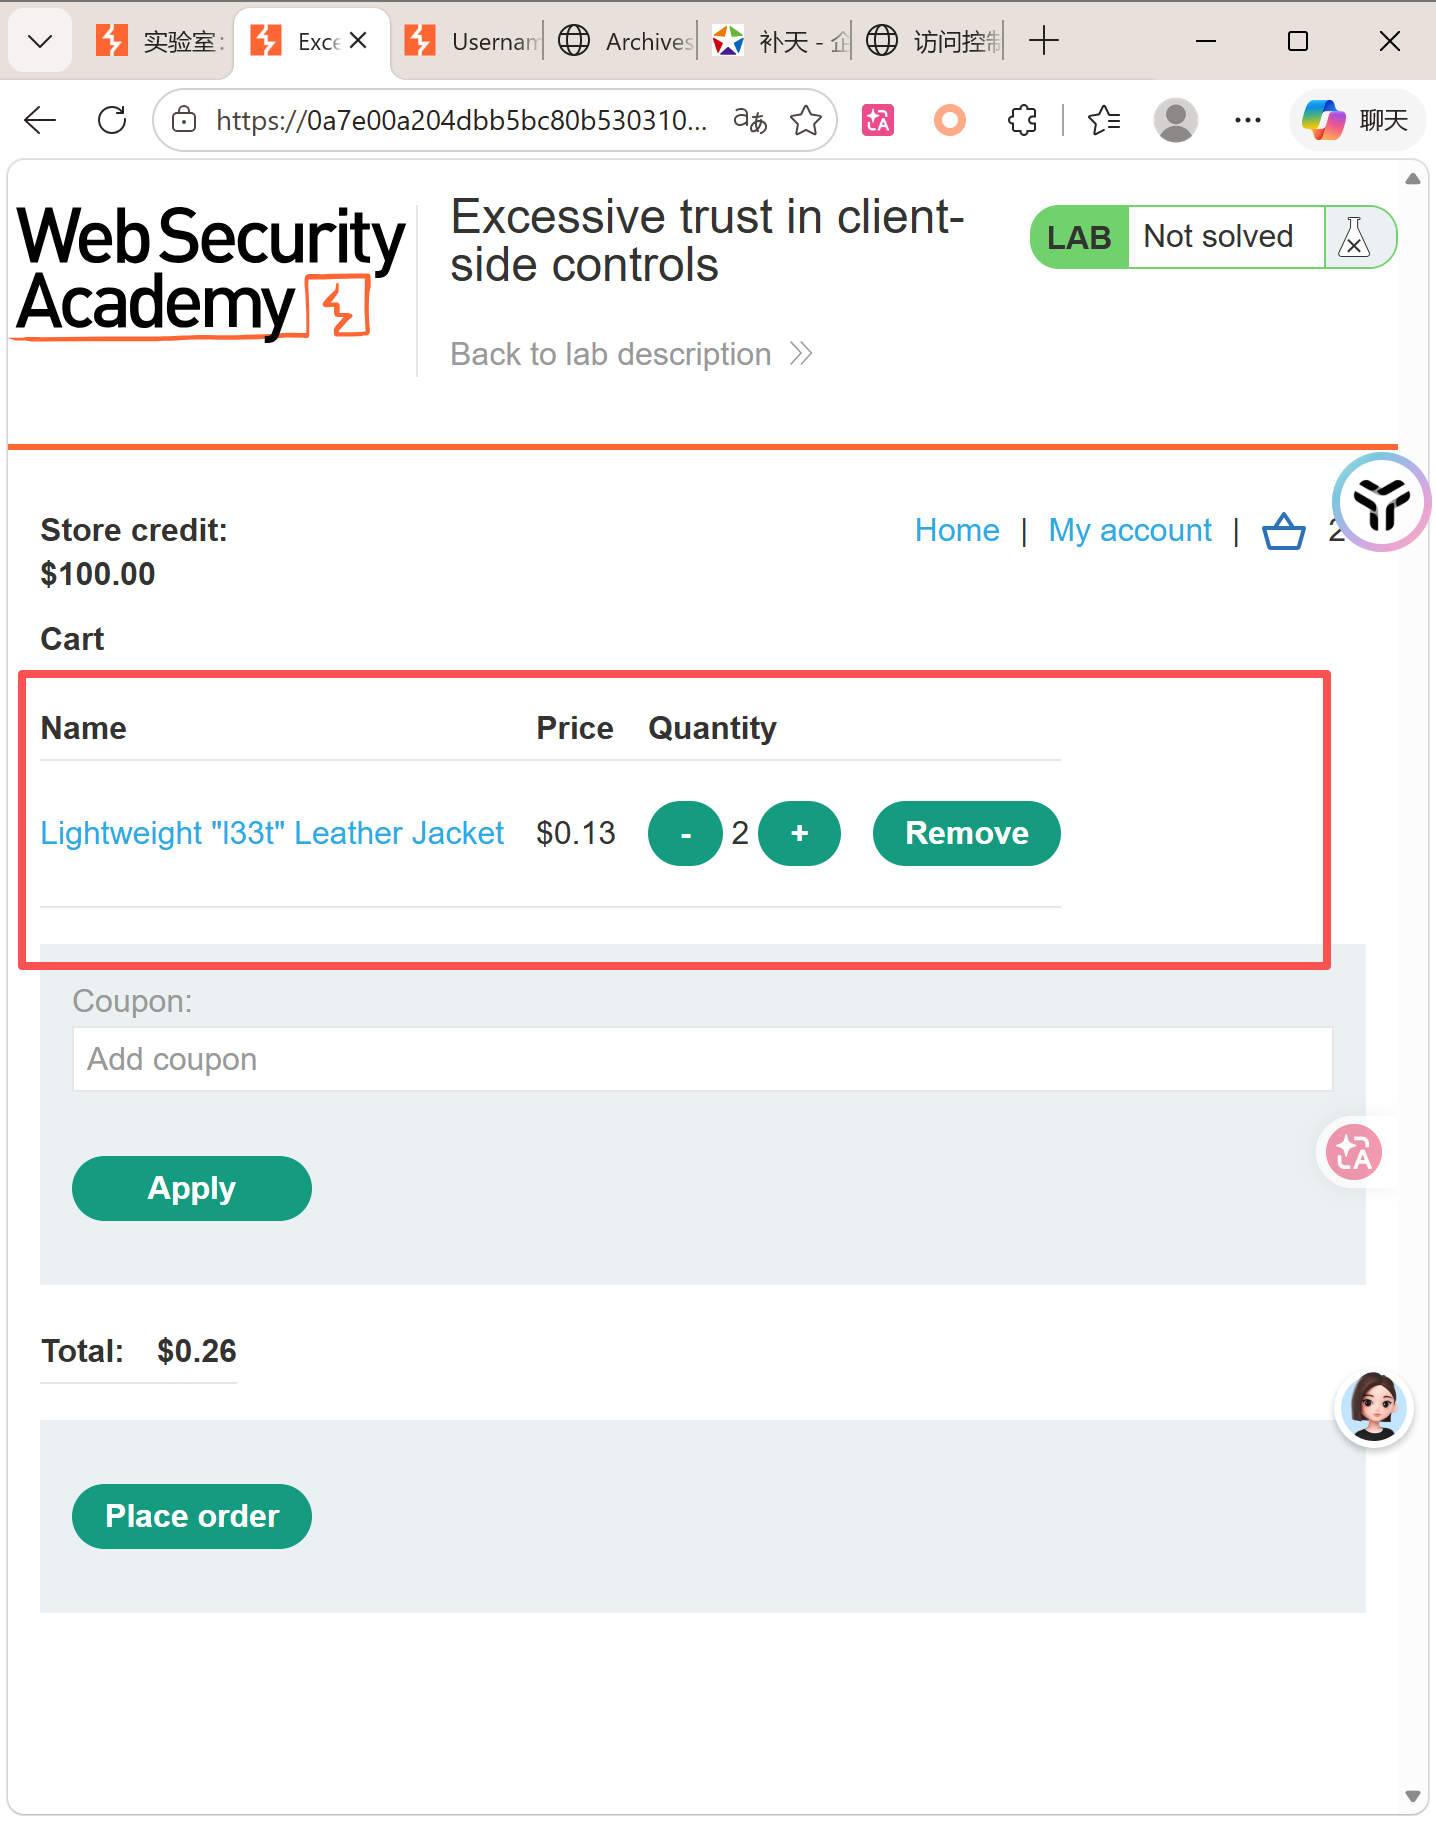
放行之后过来,价格直接变了。
成功创建订单
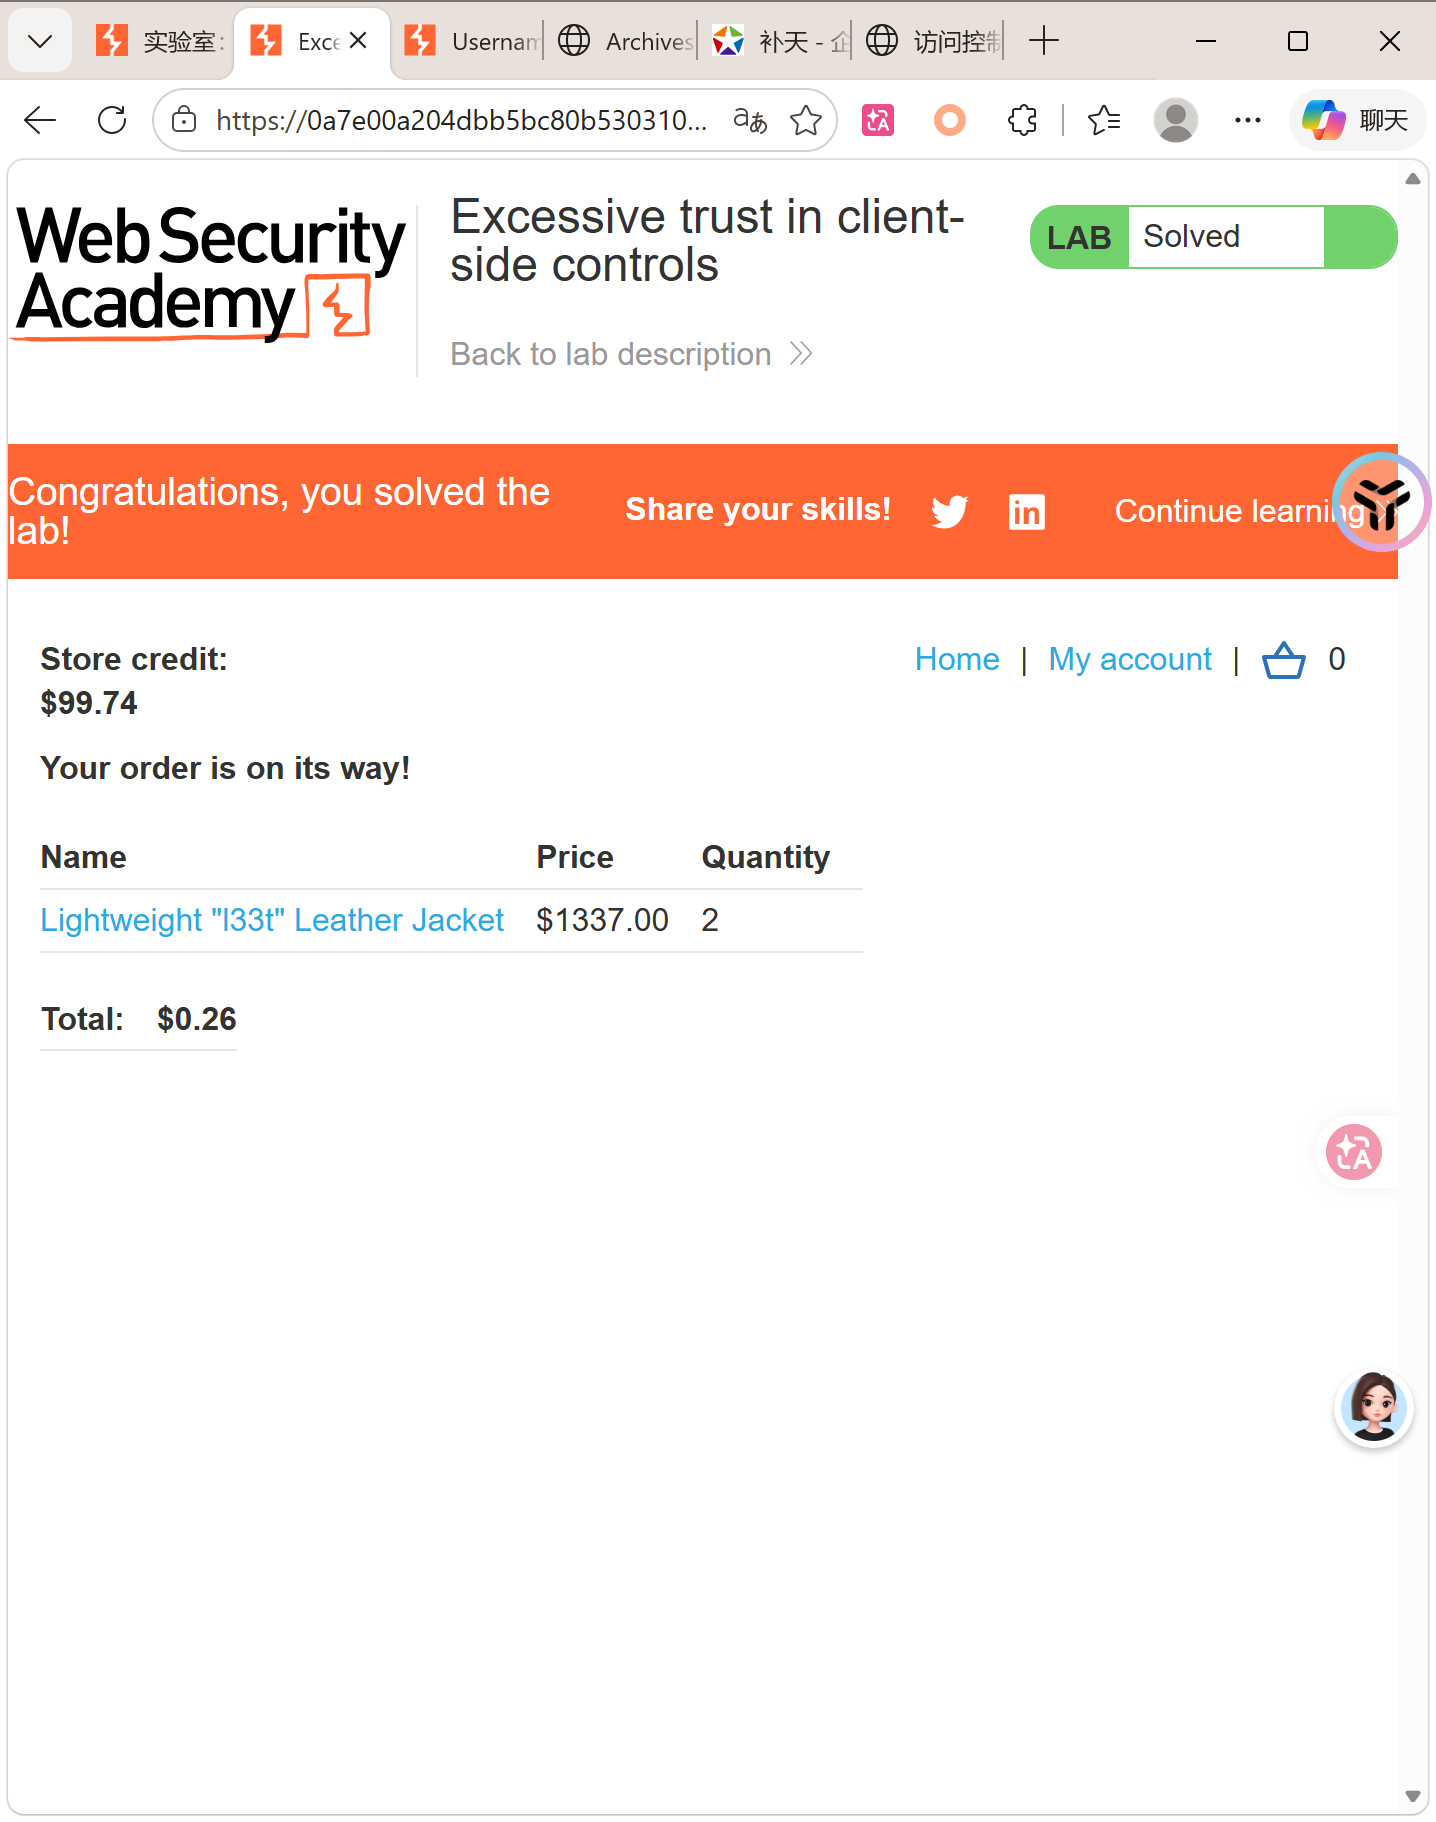
我后面又抓了一下创建订单这一步,
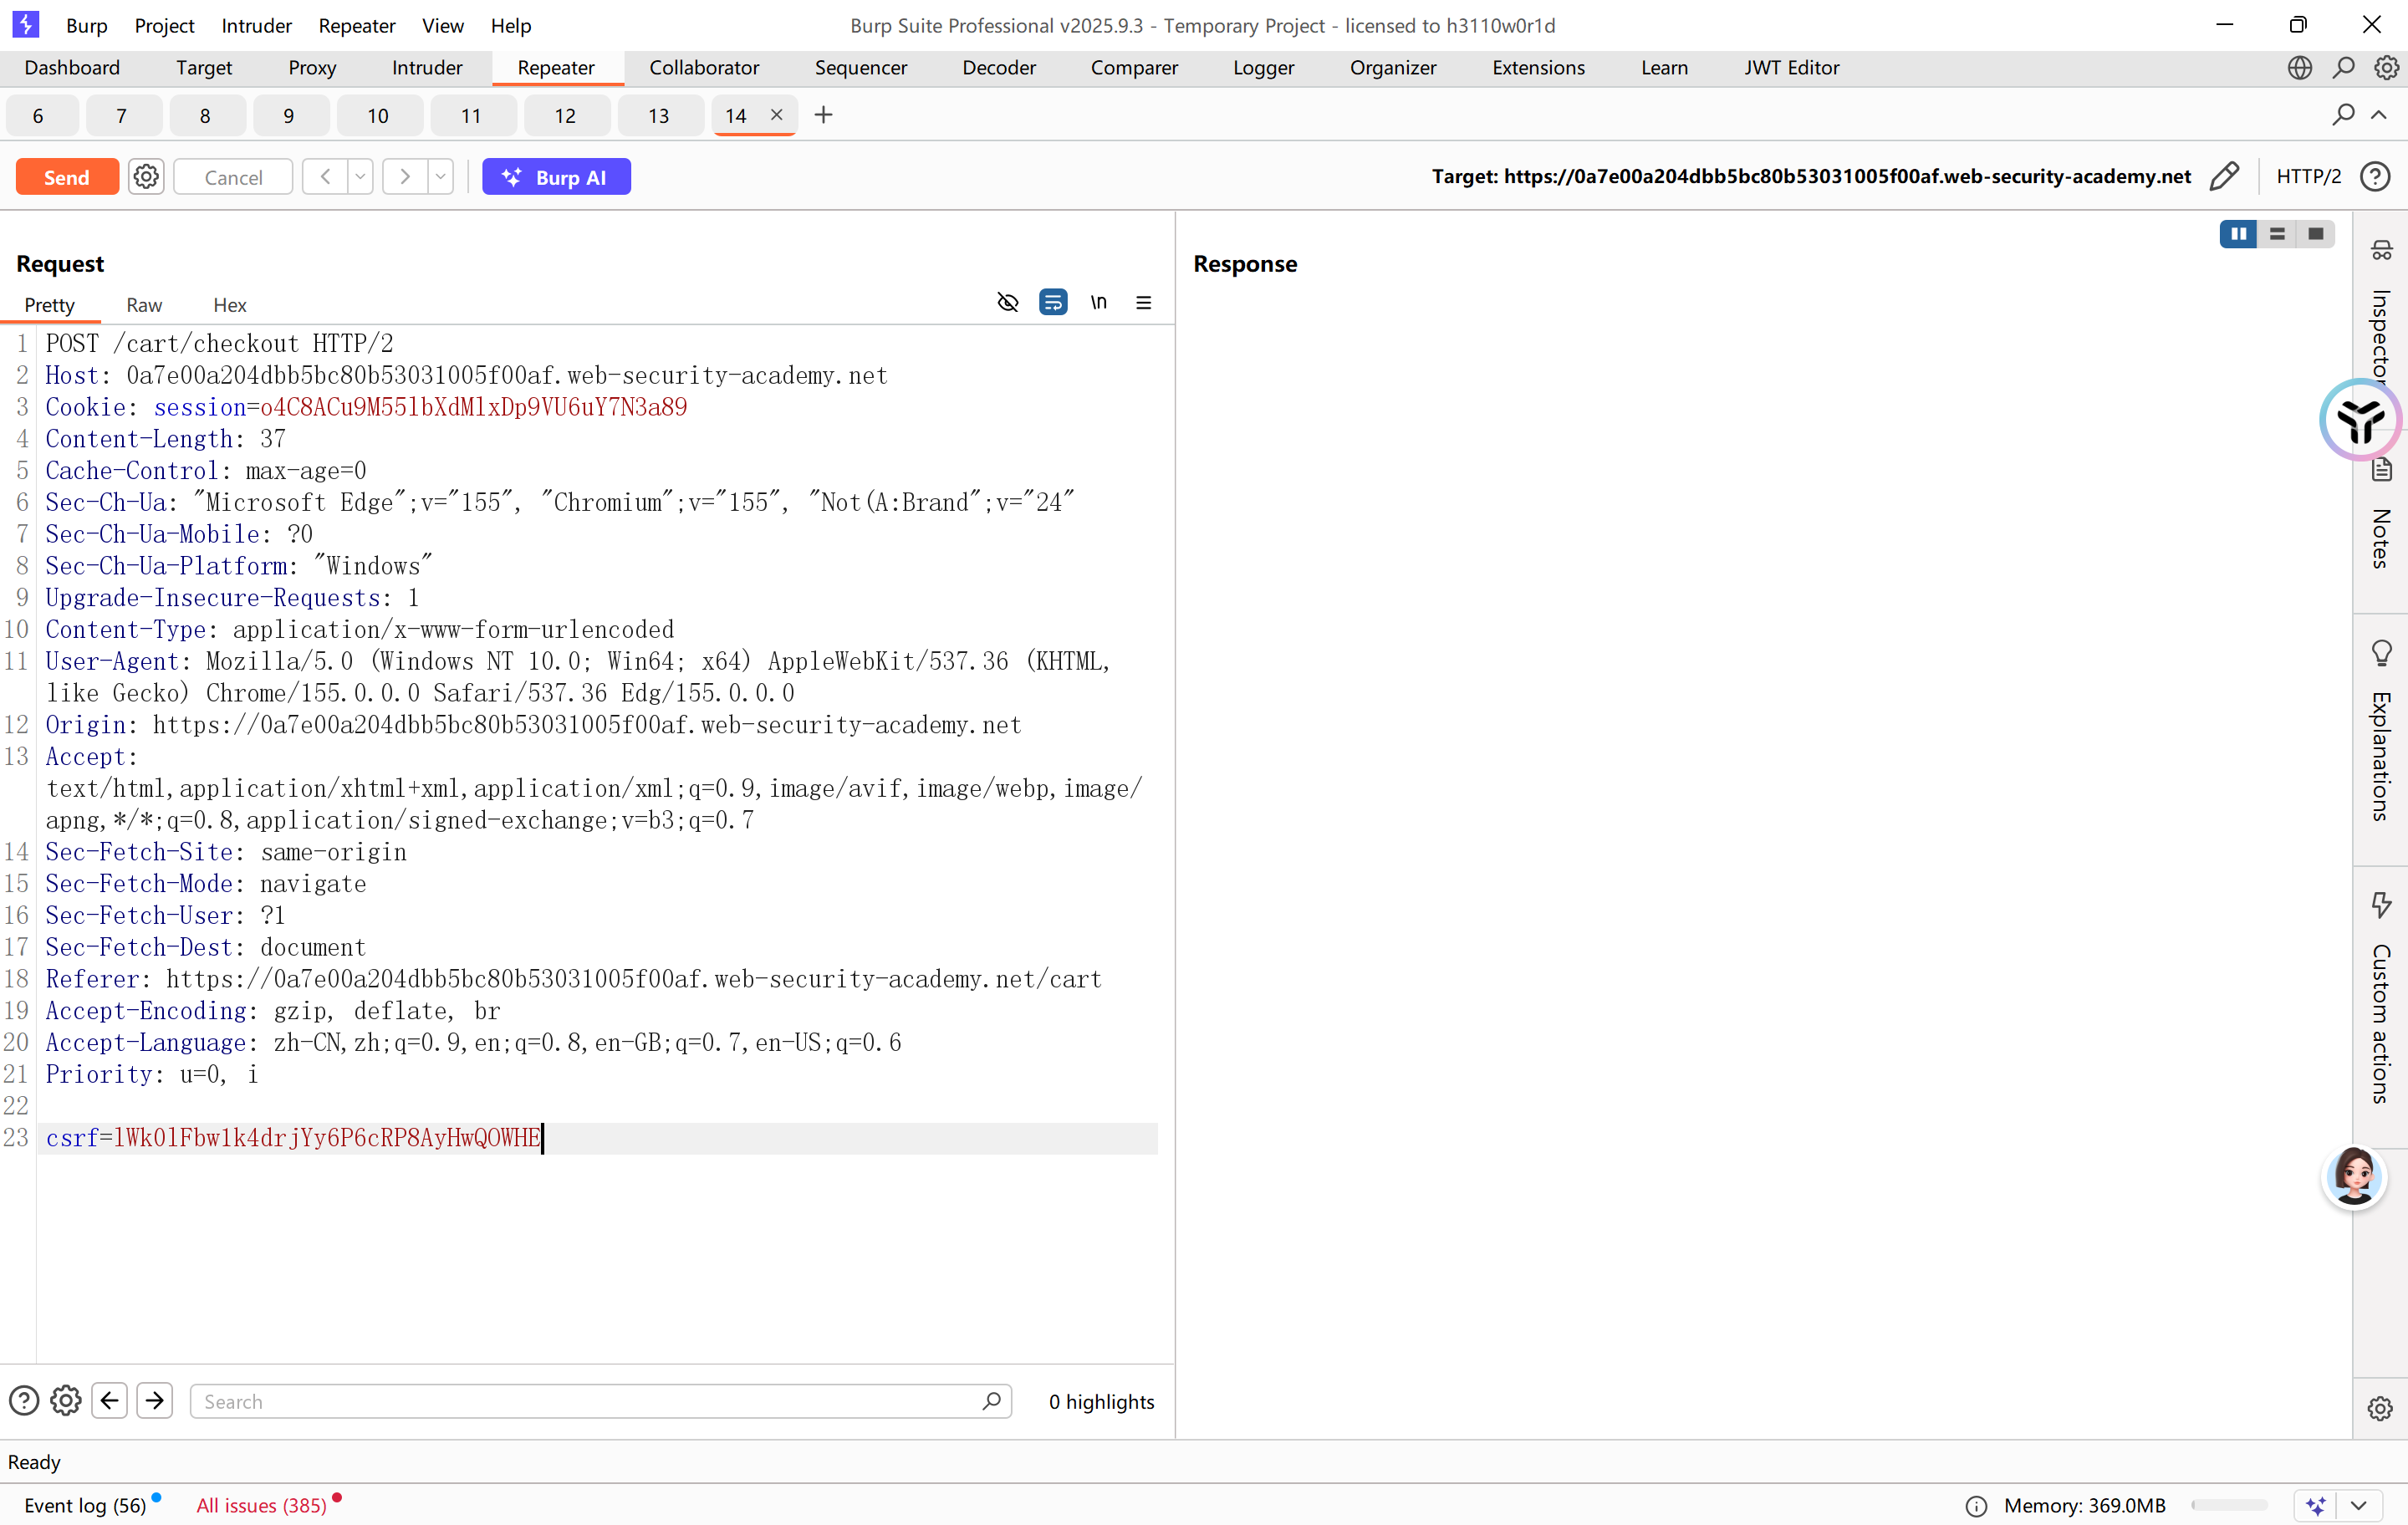
读取你购物车里已经有的商品和总价 → 对比你的账户积分 → 积分够就扣积分、生成订单;积分不够就拒绝。
它不会再查一遍商品原价,默认 “购物车里的价格就是对的”
复盘:
这道题的业务逻辑是这样的,在POST /cart加购这里,把商品 ID、数量、price价格等参数传给后端,POST /cart/checkout提交订单这里,并未对参数进行验证。
正常逻辑应该是什么样的?
- 加购时,客户端只传「商品 ID + 购买数量」,绝对不传价格;
- 服务端根据商品 ID 去数据库查真实定价,计算总价,存入购物车;
- 结账时,服务端再次根据商品 ID 重新计算一遍总价,和购物车数据做比对,确保一致后再扣款。
==所有敏感数据(价格、金额、权限)都必须以服务端为准,绝对不能信任客户端提交的结果。==
场景:数量边界校验缺失
这道题很好玩,骚操作hhhh
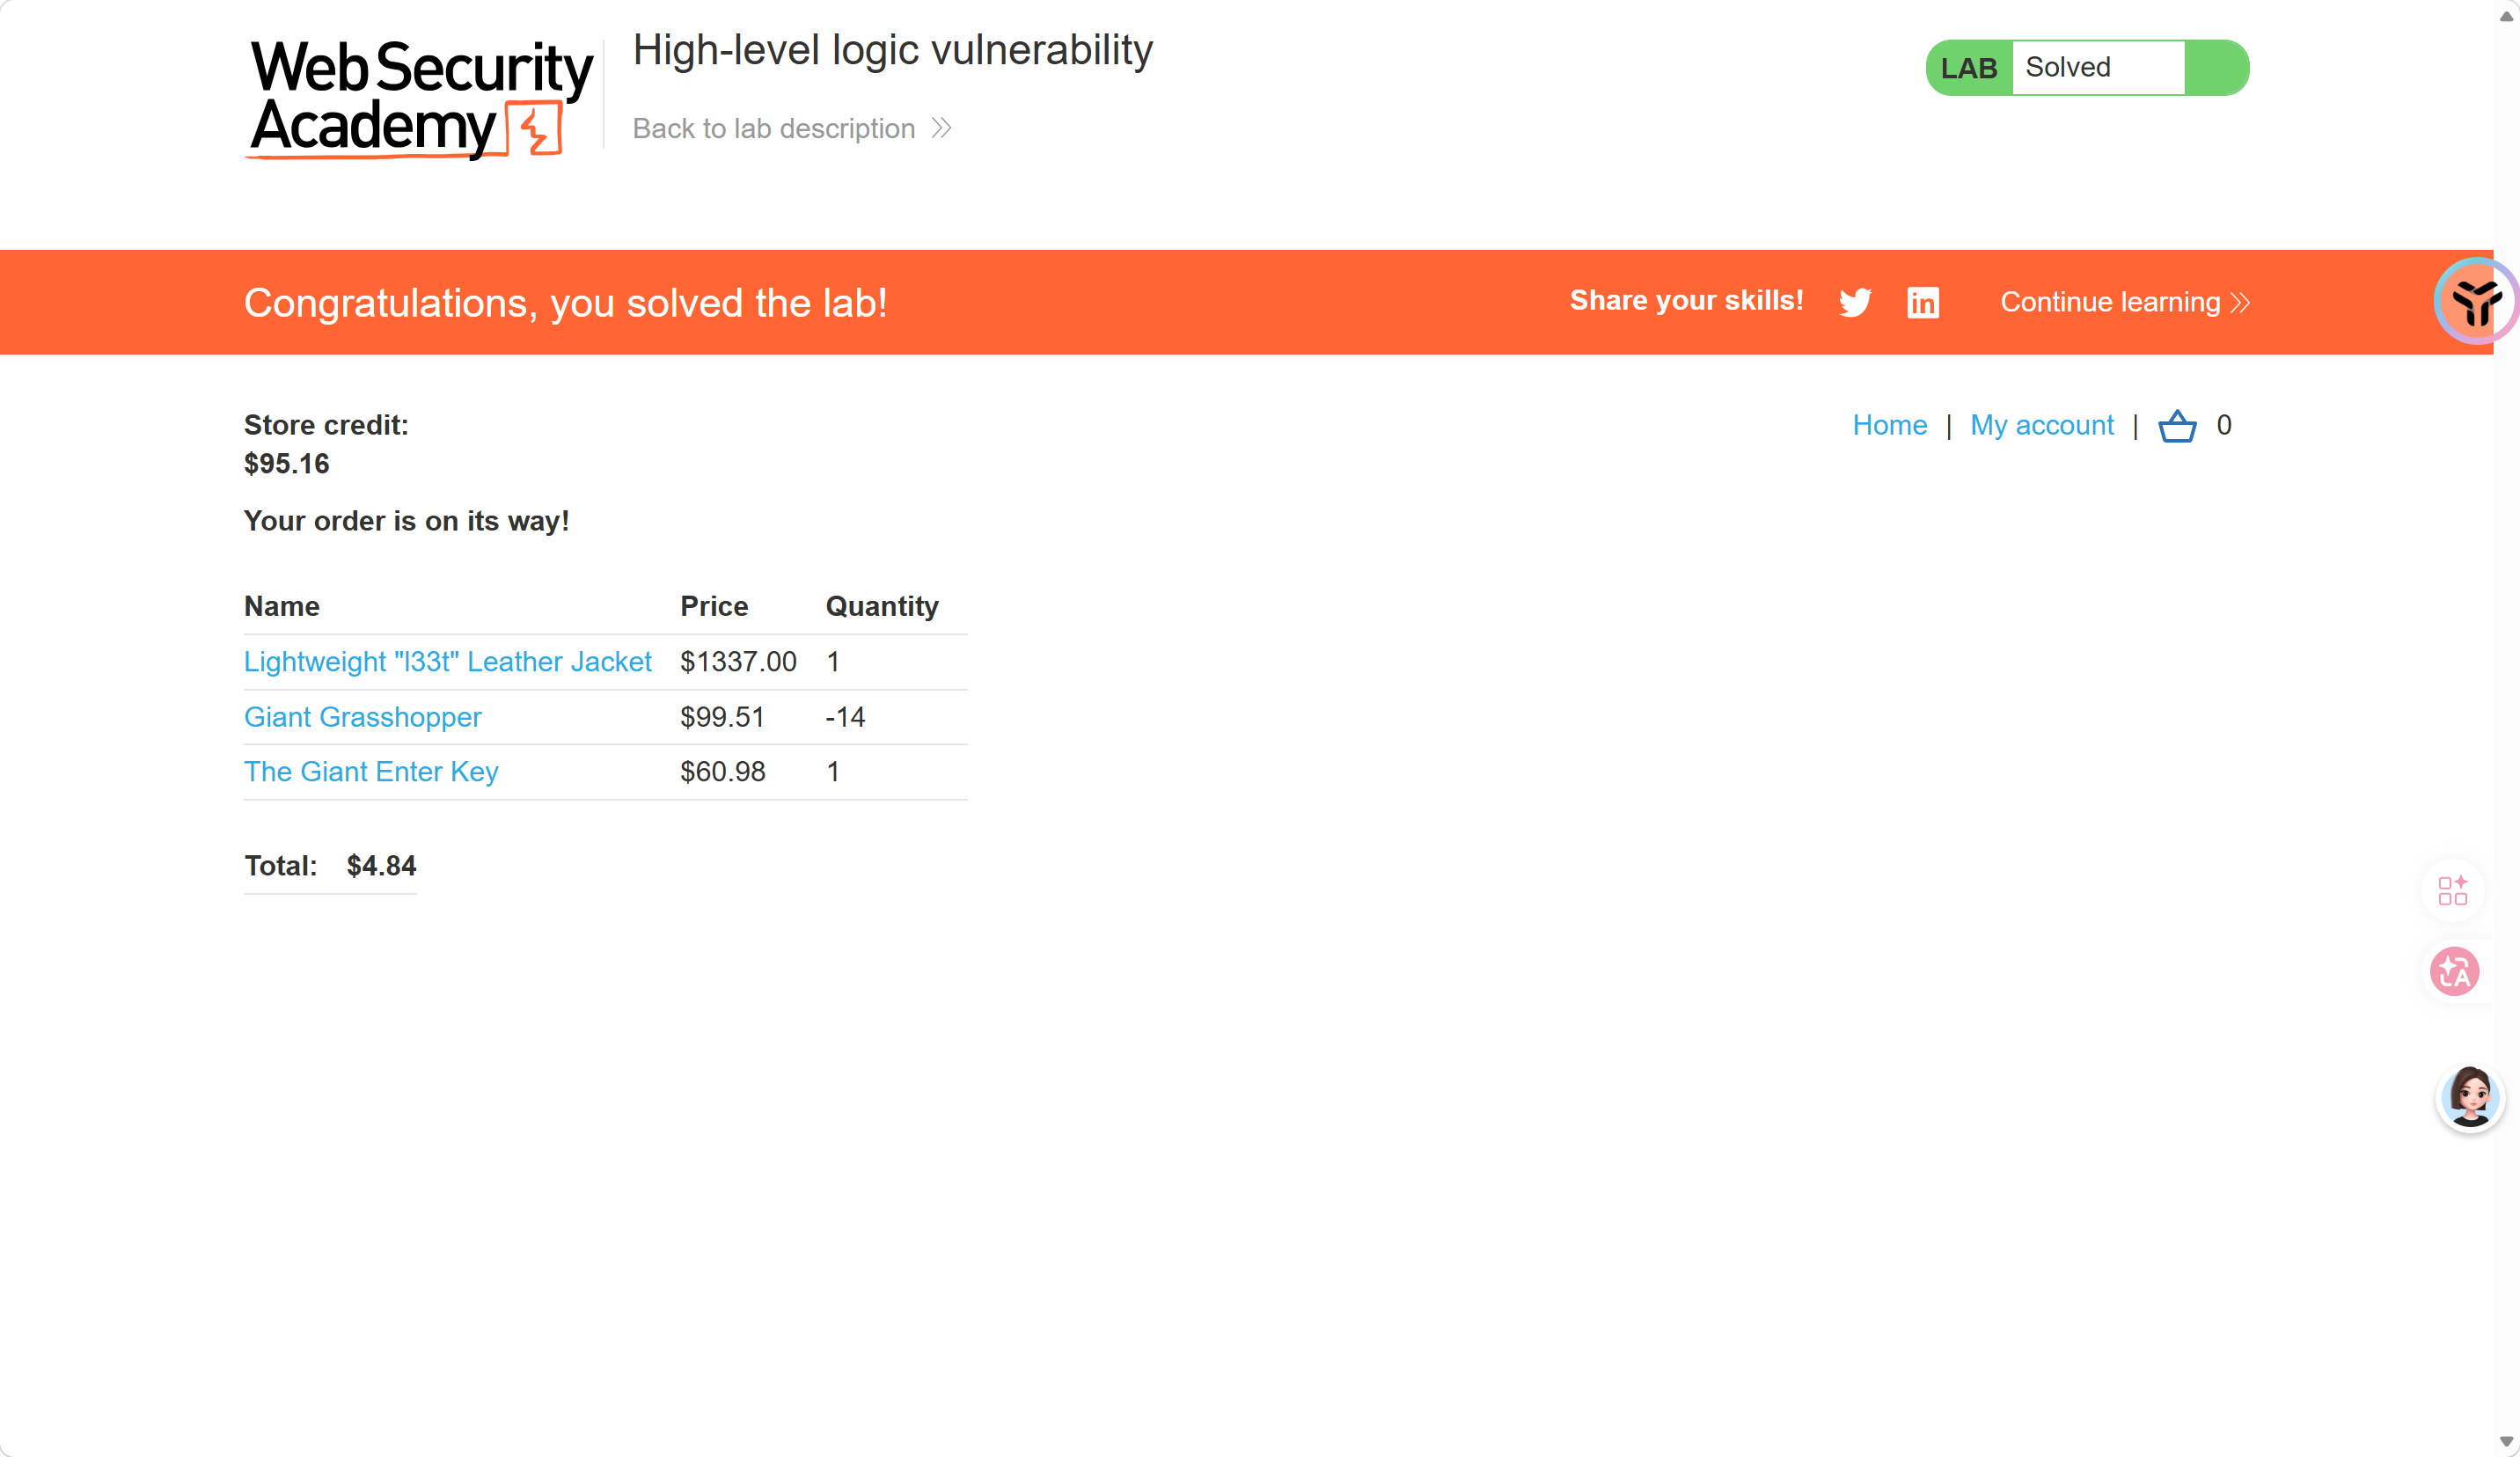
题目是这样的,服务器端接受负数的商品数量,然后付款时只校验总价是否大于0,商品数量是没管的。
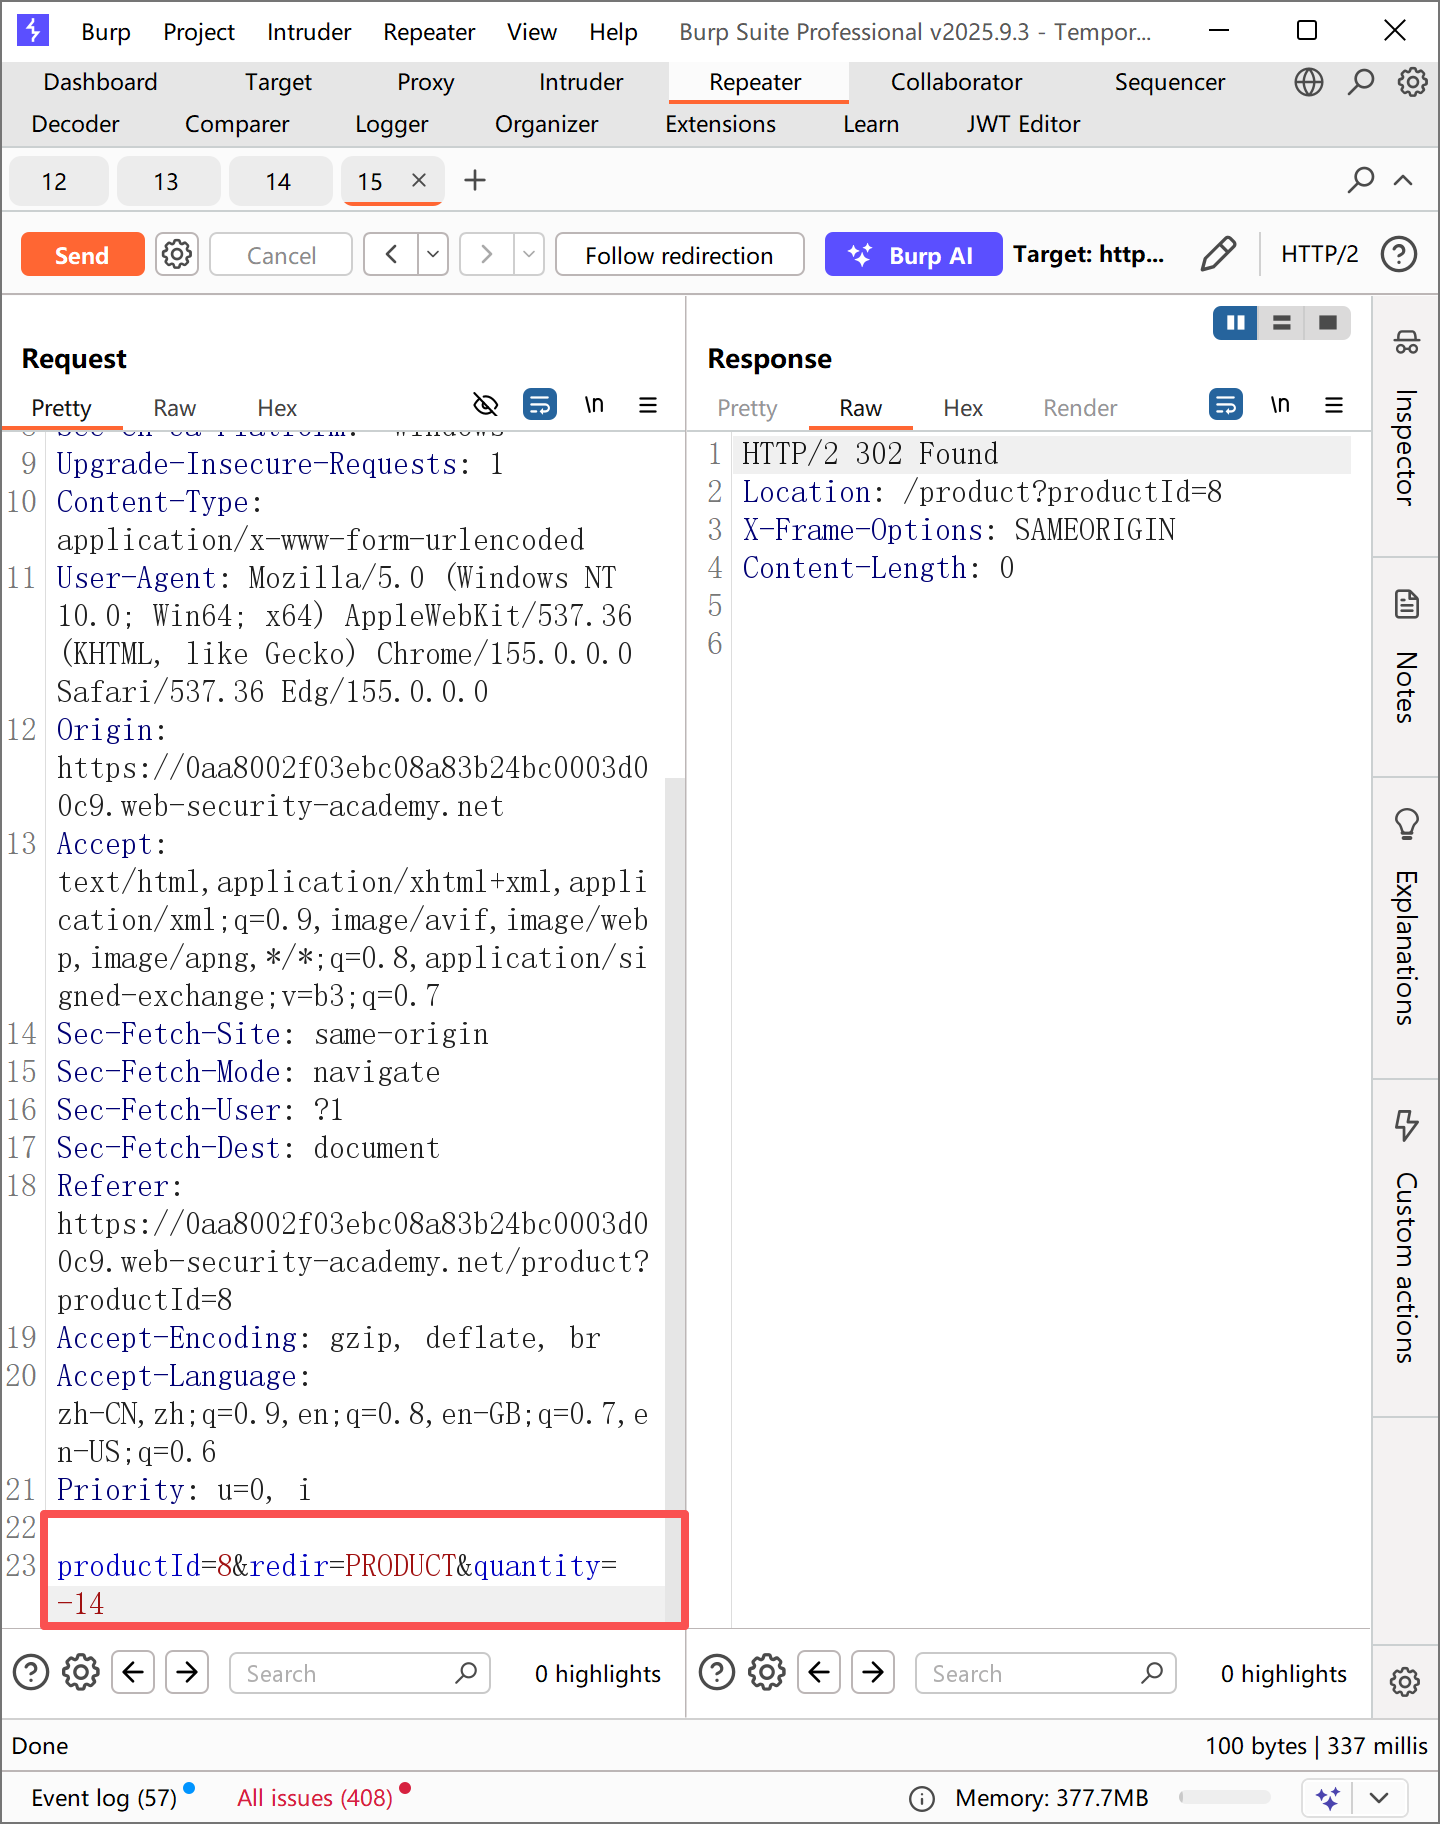
然后就给了我们操作的空间。先添加负数量的商品,让这部分扣的钱大于我们想买的商品的价格,再找一个价格低的商品把这部分的差价覆盖为0,就可以用尽量少的价格买到这个商品。
我本来还想过直接负数扣款,让它送我点钱,发现不行,这里是有校验的hhhh,太贪了
修复:
- 强校验数量参数:服务端必须校验
quantity必须是 ≥1 的正整数,负数、0、非整数直接拒绝。 - 结算二次校验:结算环节重新遍历购物车商品,逐件校验商品单价、数量合法性,重新计算总价,不直接使用购物车缓存的数值。
- 库存逻辑联动:数量变更要和库存校验联动,负数量本身就不符合业务逻辑,直接拦截。
这类漏洞的本质还是那句安全铁律:永远不要信任客户端提交的任何参数,哪怕是看起来 “只会是正数” 的数量,也要在服务端做边界校验。
==数量型逻辑漏洞的挖掘方式:==
第一步:先把所有「数量类参数」全定位出来
不用漫无目的地翻包,在 Burp 的 HTTP History 里直接搜索关键词,就能快速锁定目标:
- 常见参数名:
quantity、count、num、amount、qty、change、add - 常见接口:加购、修改购物车数量、充值、积分兑换、投票、点赞、下载次数、邀请人数
只要是「代表个数、次数、金额」的数值参数,全部归为这一类,拉出来逐个测。
第二步:按「边界值测试清单」逐个测(核心)
拿到一个数量参数,不要上来就直接改负数,按这个顺序测,形成肌肉记忆:
- 测 0:数量 = 0,看看会不会生成 0 元订单、0 数量商品
- 测 极小负数:先改
quantity=-1,这是命中率最高的 —— 很多开发做了 “减 1” 的逻辑,但没限制最小不能小于 0 - 测 大负数:
quantity=-100、quantity=-99999,看会不会出现负总价、负余额 - 测 极大正数:
quantity=99999999,测库存溢出、总价溢出 - 测 小数:
quantity=1.5,测会不会按 1.5 件计算价格 - 测 非数字:传字母、特殊符号,看会不会报错泄露逻辑
实战小窍门:如果这个接口本身就有 “减少” 功能(比如购物车减号、取消兑换),直接抓包看它减的时候传的是什么。 很多系统减数量就是传
quantity=-1,那你直接把-1改成-1000,大概率能成 —— 这等于开发自己告诉你 “这个参数支持负数”,只是限制了大小。
第三步:不要只看响应,必须「验证实际业务效果」
很多新手改完参数看响应是 200 就以为成了,或者看响应里报错就以为不行,这都不对。 必须做这一步验证:
改完参数发出去后,回到前端页面刷新,看真实的业务数据有没有变
- 购物车场景:数量、总价是不是真的按你改的数值更新了
- 账户场景:积分、余额有没有异常增减
- 哪怕响应返回 “操作成功”,也要看实际数据;哪怕响应返回 “参数错误”,也要刷新页面试试 —— 很多时候只是前端提示错了,后端已经执行了。
场景:
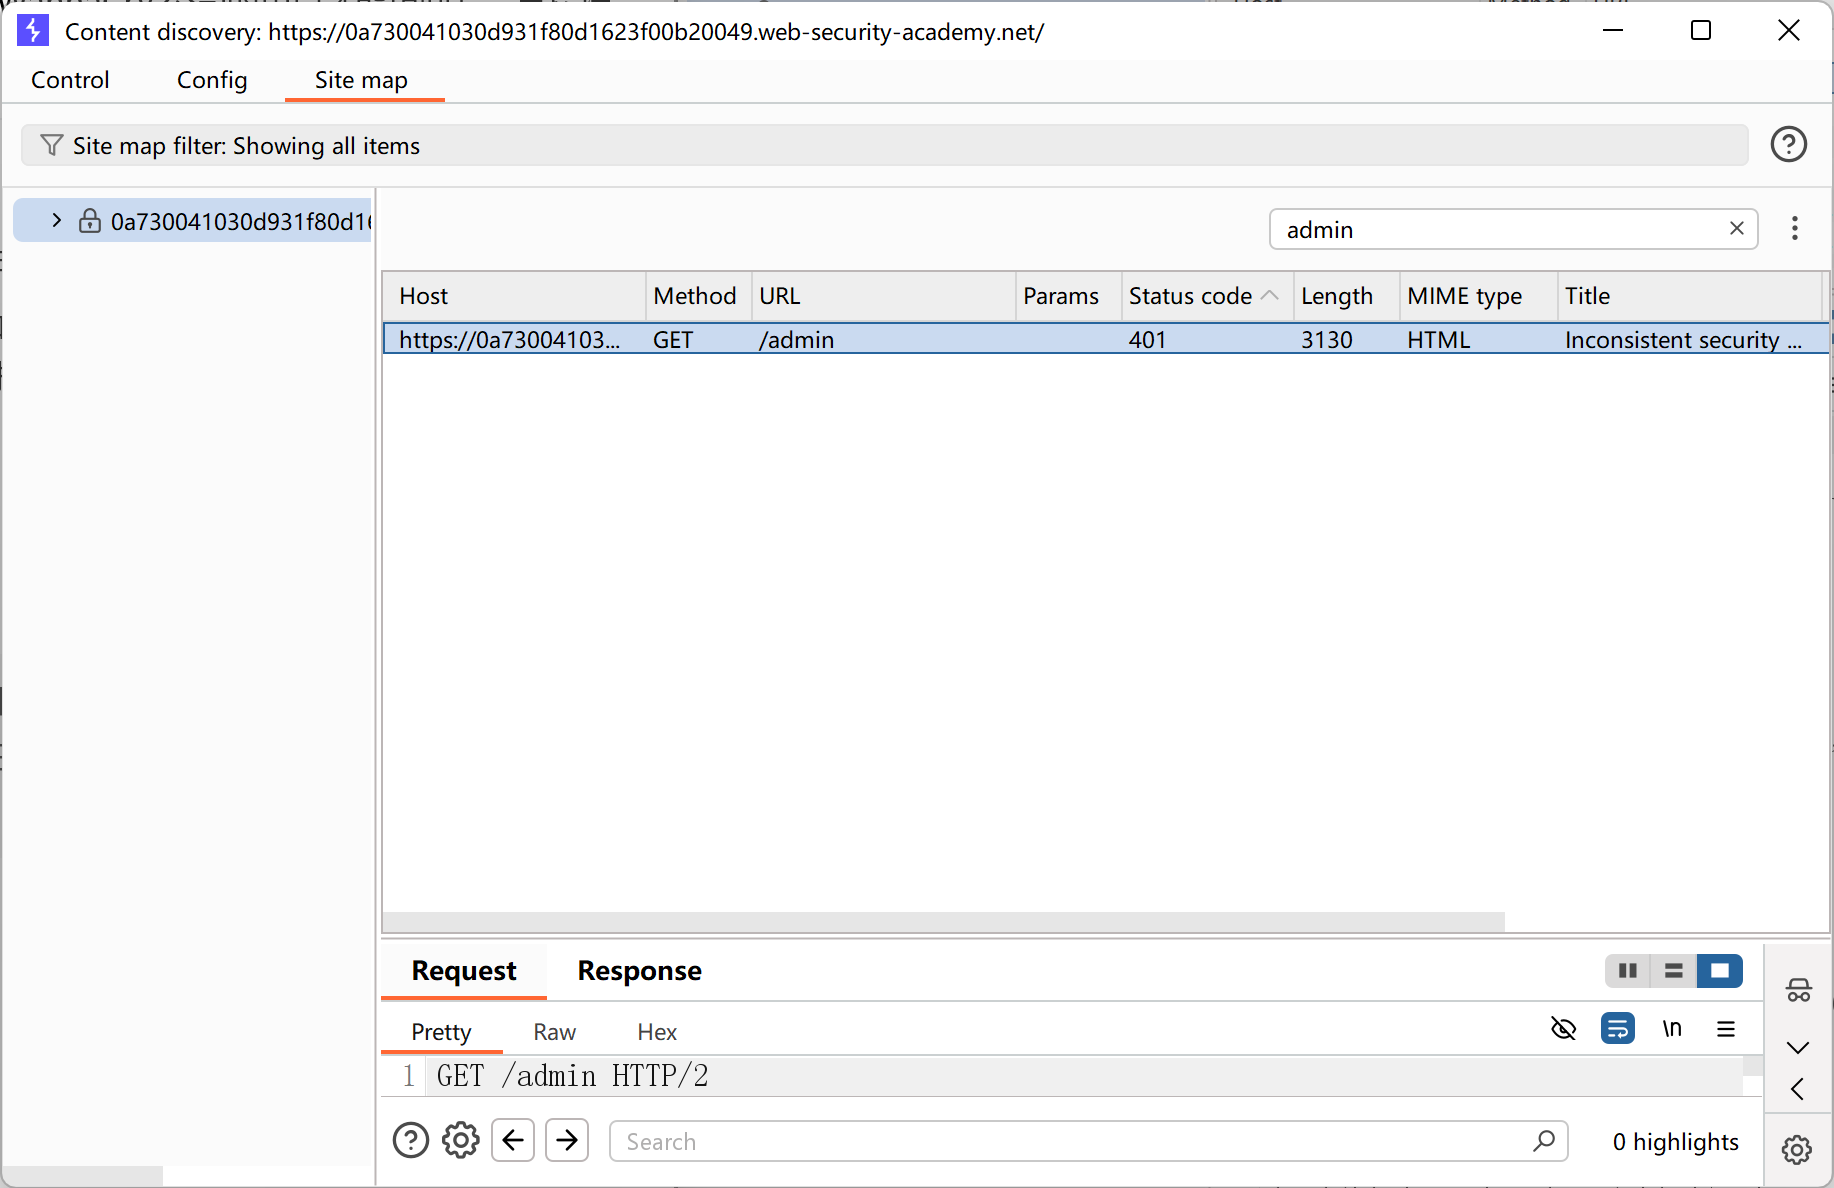
用bp做sitemap扫描。
发现admin路径,进去
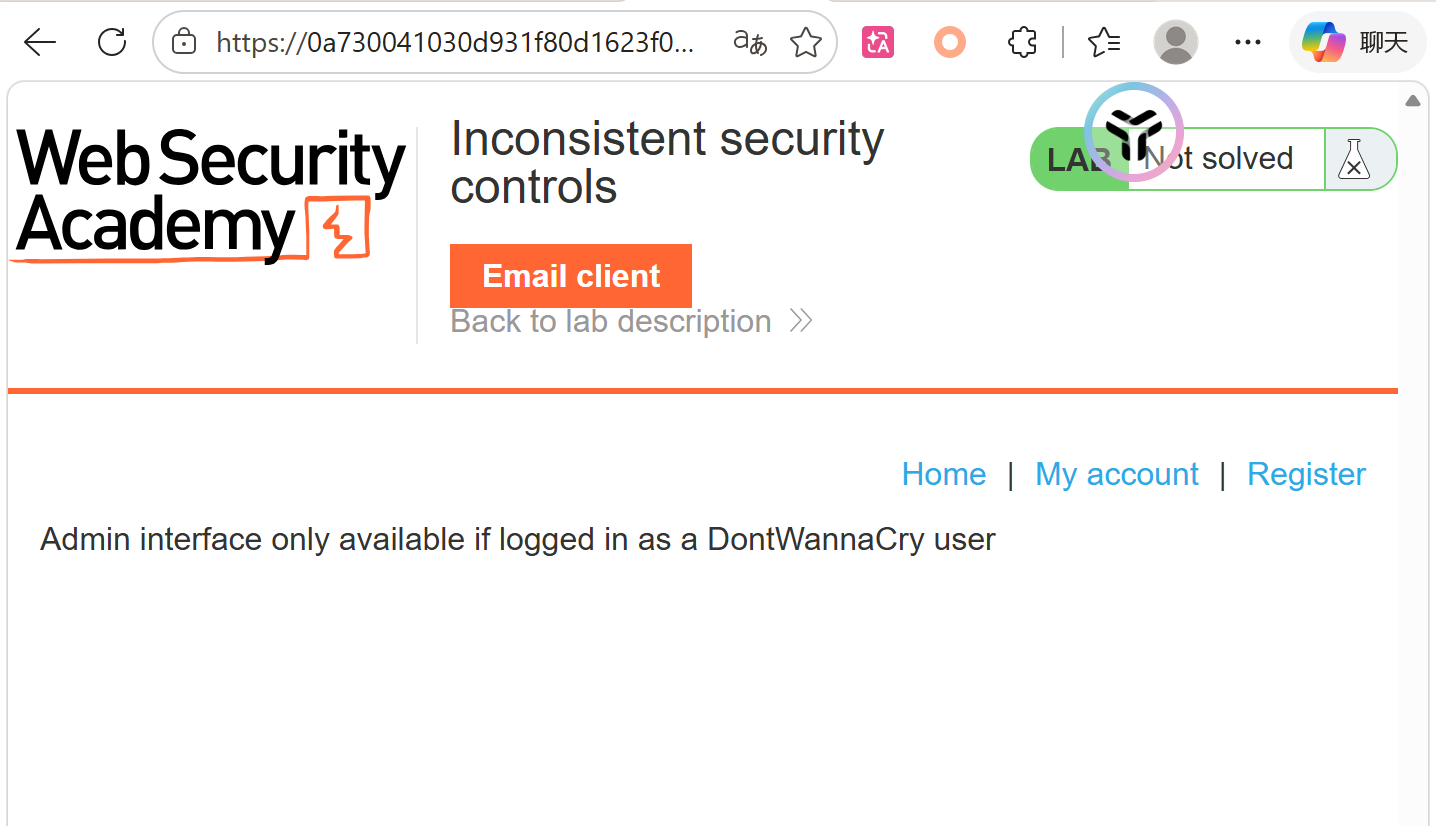
是被拦截的
注册邮箱之后登录。
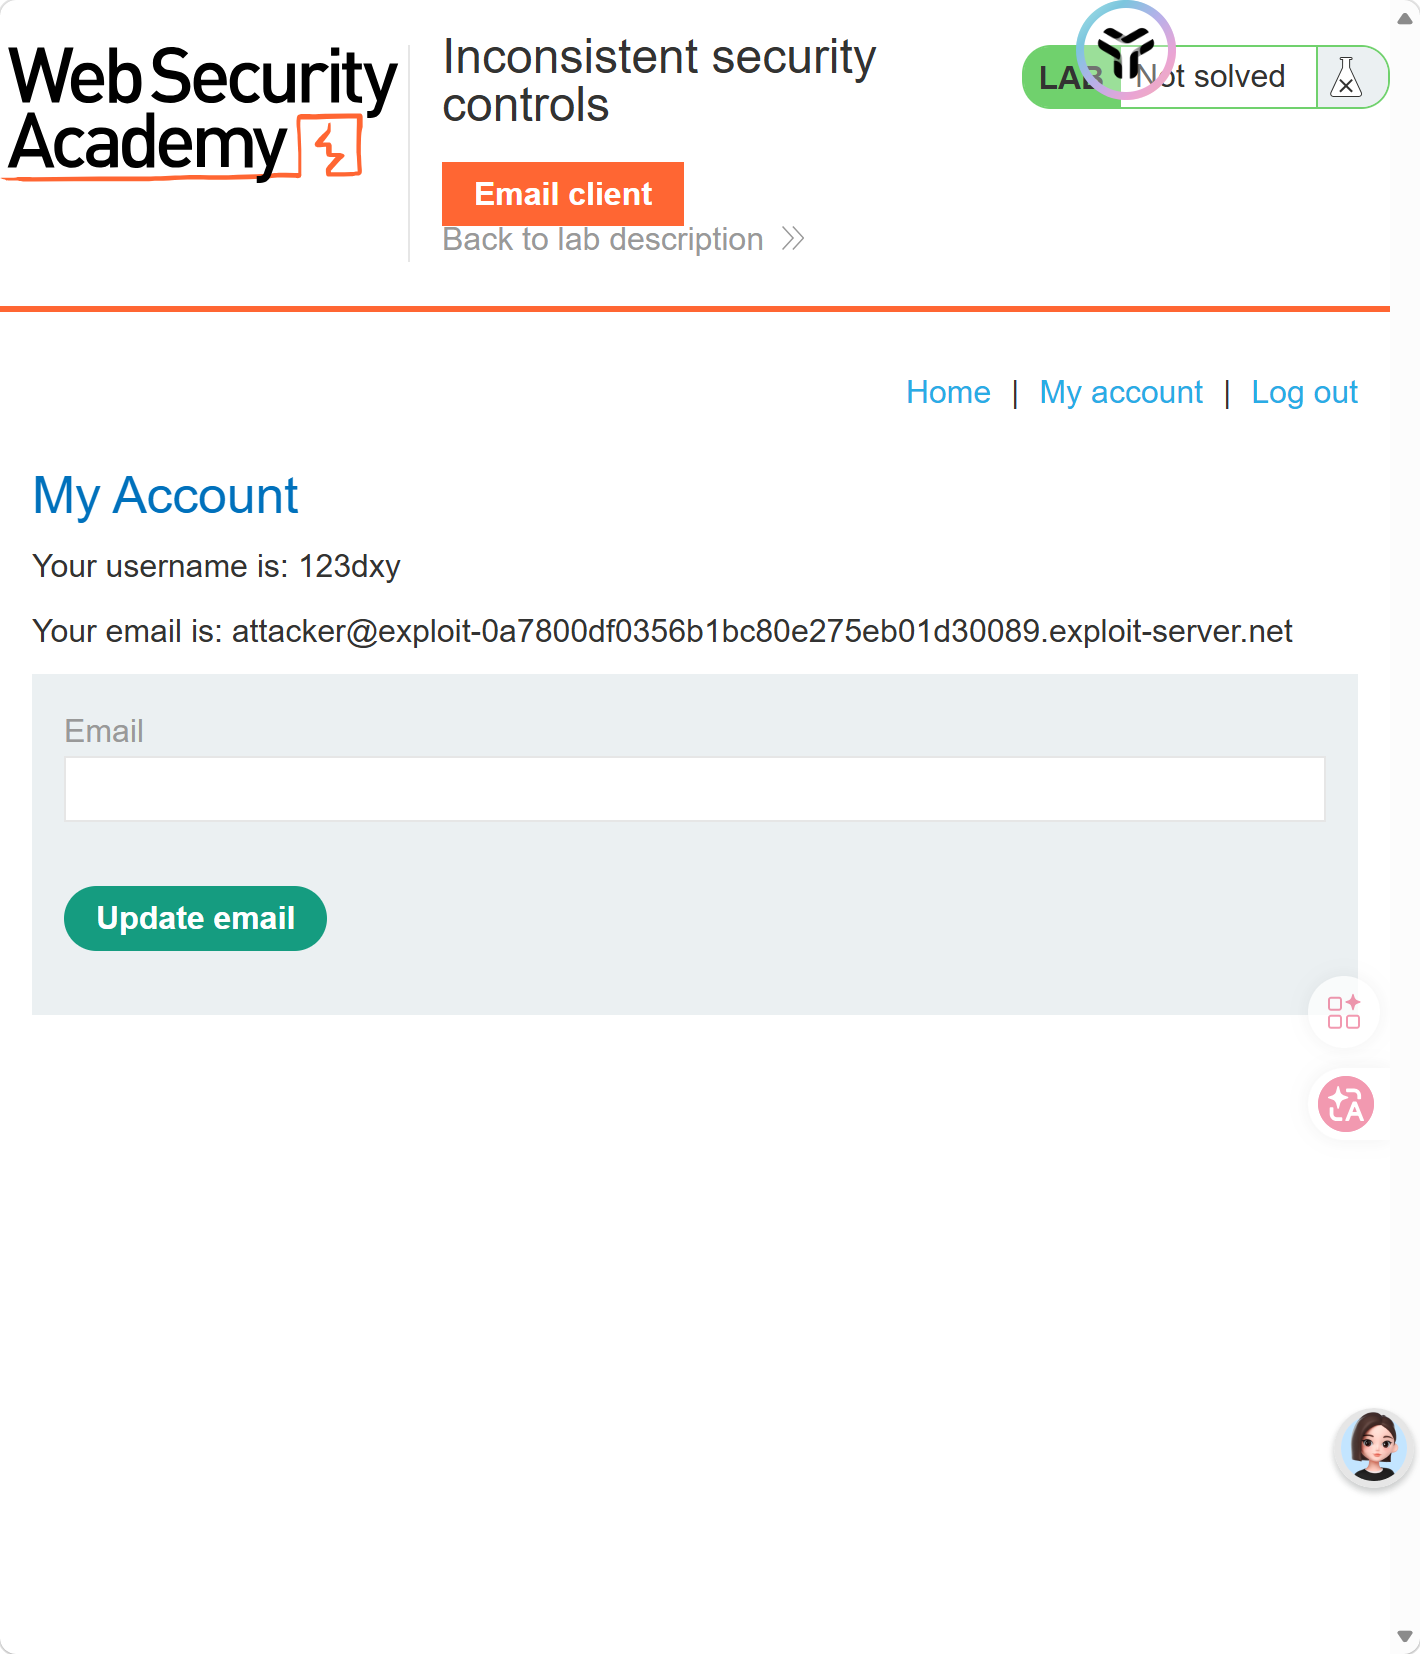
注册账户之后直接更改
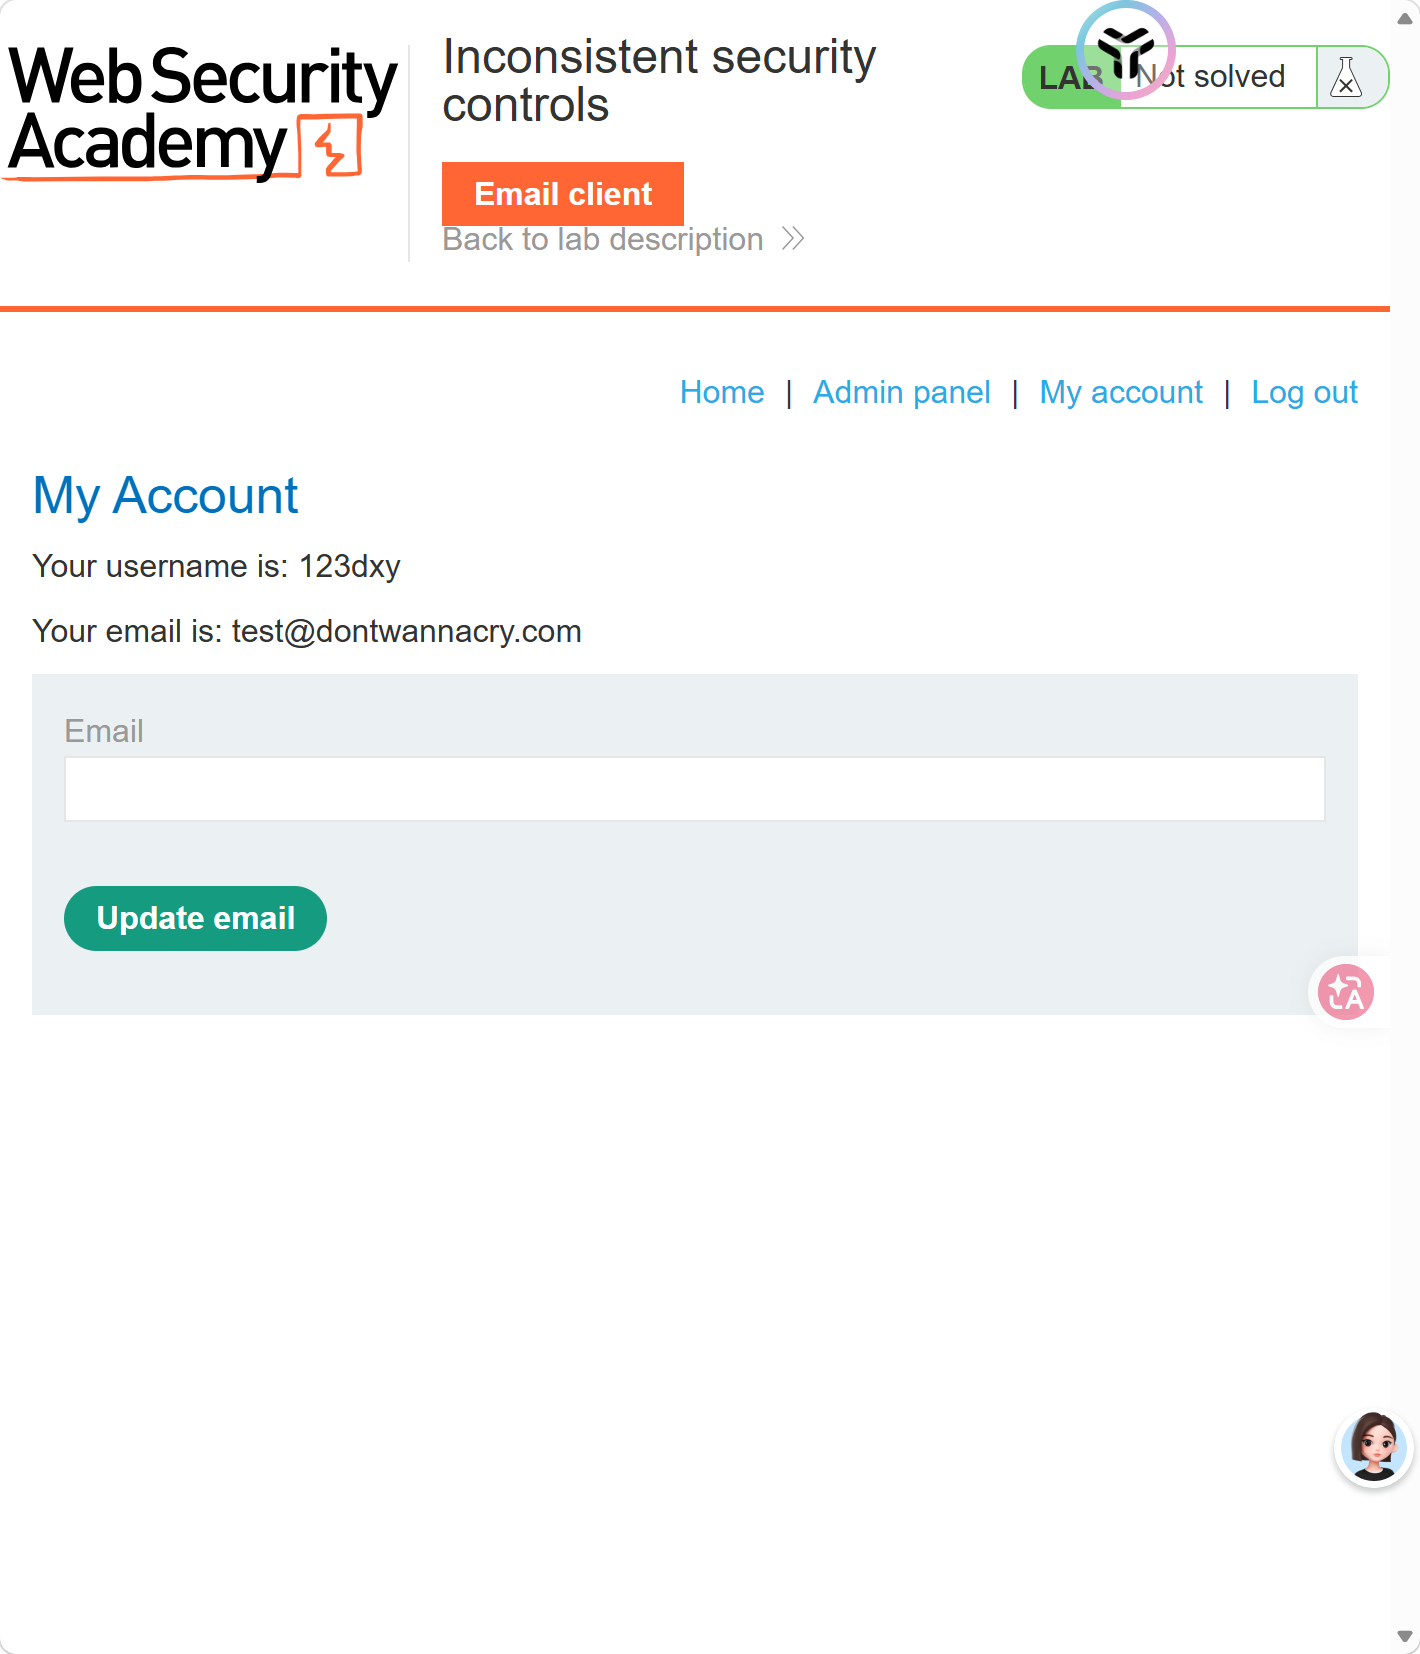
再进去就能通过了。
修复方案:
- 修改邮箱必须和注册同标准校验:修改邮箱时,必须向新邮箱发送验证链接,点击确认后才能修改成功,确保用户对新邮箱有所有权。
- 权限校验不能只依赖单一可篡改字段:员工身份不能只靠邮箱后缀判断,应该配合员工表、角色权限表、工号等多重校验。
- 敏感页面增加二次权限验证:管理面板除了判断公司身份,还要校验用户角色是不是管理员,不能所有公司用户都能进入。
- 报错信息脱敏:不要明确告诉用户 “什么样的人能访问”,统一返回 “无权限” 或 404,避免给攻击者指明攻击方向。
核心:
==所有和权限、身份、计费挂钩的关键字段,它的每一次修改,都必须执行和注册 / 绑定时同等强度的校验。==
==只要有一个修改入口校验松了,整个权限体系就等于破了。==
信号 1:报错信息直接泄露了准入规则
就像这道题访问 /admin,报错明确告诉你「只有 DontWannaCry 公司用户能访问」。 实战里非常常见:
- 后台报错「请使用企业邮箱登录」
- 会员页面提示「仅限 VIP 用户访问」
- 渠道系统提示「仅合作商户可进入」
新手最容易犯的错:看到无权限就退走了。实际上这不是阻碍,这是送线索—— 它直接告诉你「系统是靠什么字段判断权限的」。接下来你只要去找改这个字段的入口就行。
信号 2:系统用「用户可编辑的字段」当权限判断依据
只要权限是靠这些字段判断的,一律重点排查:
- 邮箱后缀(判断是不是企业员工)
- 用户类型 / 角色字段(
user_type、role、is_vip) - 公司 ID、商户 ID、渠道标识
- 手机号归属、企业认证标识
核心判断:这个字段用户能不能自己改? 能改,就有控制不一致的风险。
信号 3:入口校验严格,但有修改入口
注册、绑定的时候要邮件验证、短信验证、审核;但个人中心、资料修改页面,可以直接改邮箱、改手机号、改公司信息。 只要两边校验强度不一样,大概率有漏洞。
信号 4:权限校验只做一次,只看最终值
权限判断只在访问的时候查一下你当前的字段值,不查这个值的变更记录、不校验变更渠道、不做二次确认。
测试步骤:
- 摸边界:先访问受保护的页面(后台、会员中心、企业功能),看报错,搞清楚「什么样的身份有权限」,找到判断依据字段。
- 找入口:找这个判断字段的所有修改入口:注册、修改资料、绑定更换、补全信息、甚至申诉通道。
- 比强度:对比每个入口的校验强度。注册要验证?那修改的时候要不要?绑定要审核?那更换的时候要不要?
- 绕过去:从校验最弱的入口,把字段改成符合权限要求的值,再回去访问受保护页面,验证是否绕过。
场景:商业规则执行缺陷
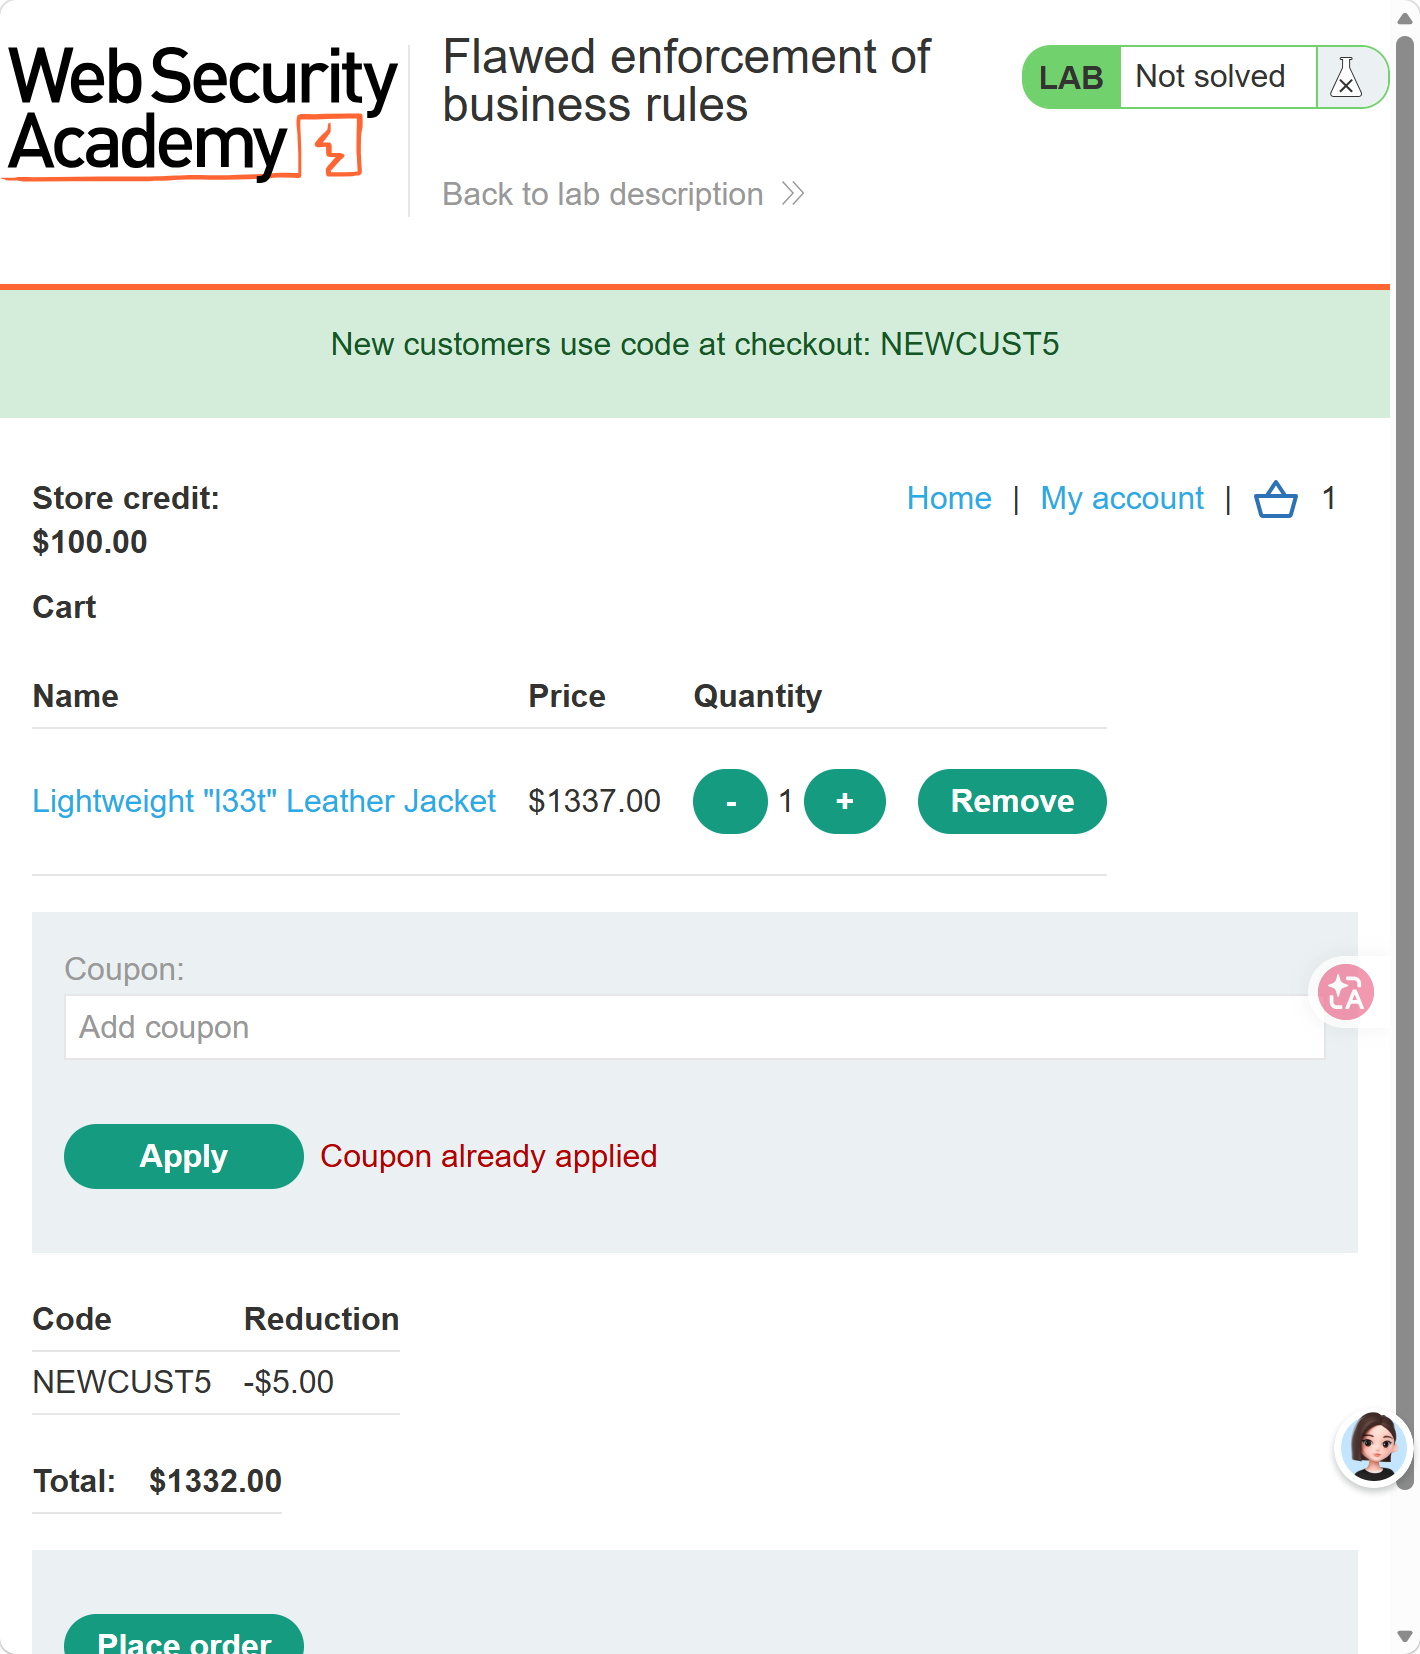
获取两张优惠券之后,单独使用1张,发现不能连续使用
交错使用结果正常
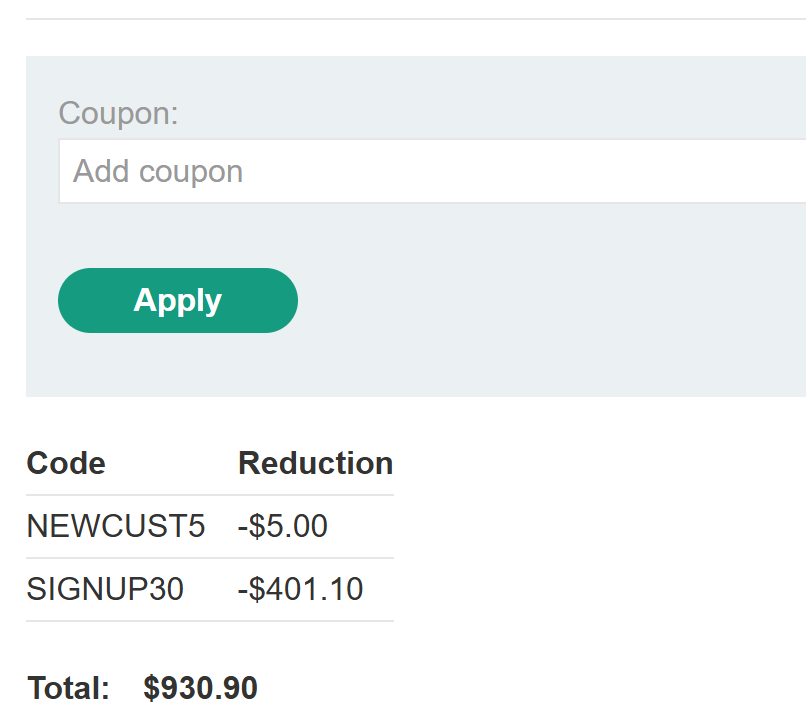
但是可以交替使用
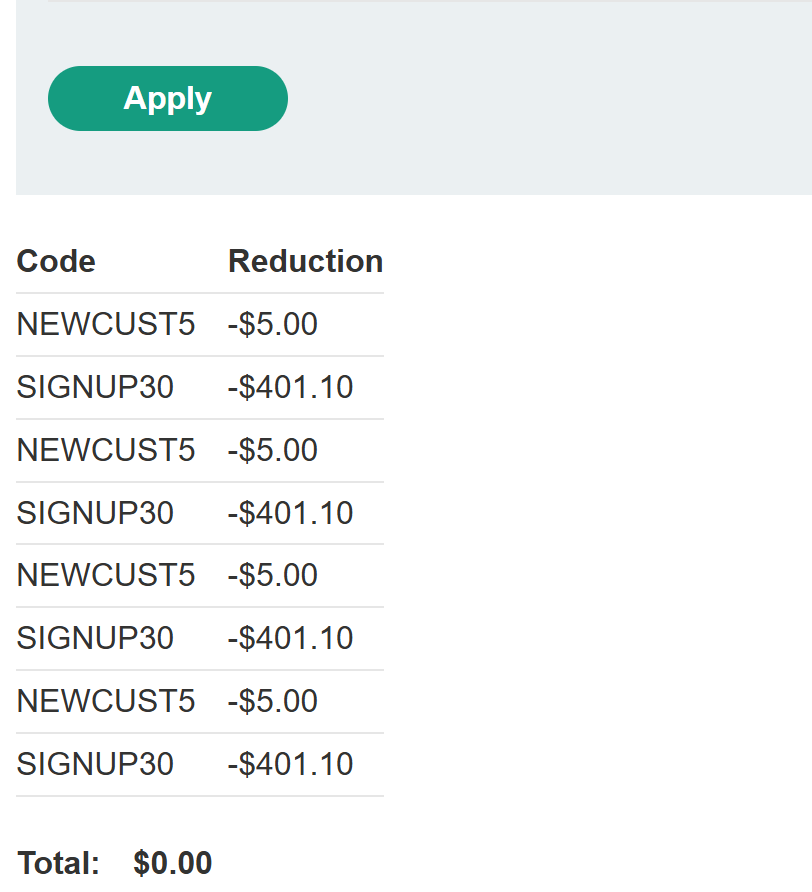
直接0元购
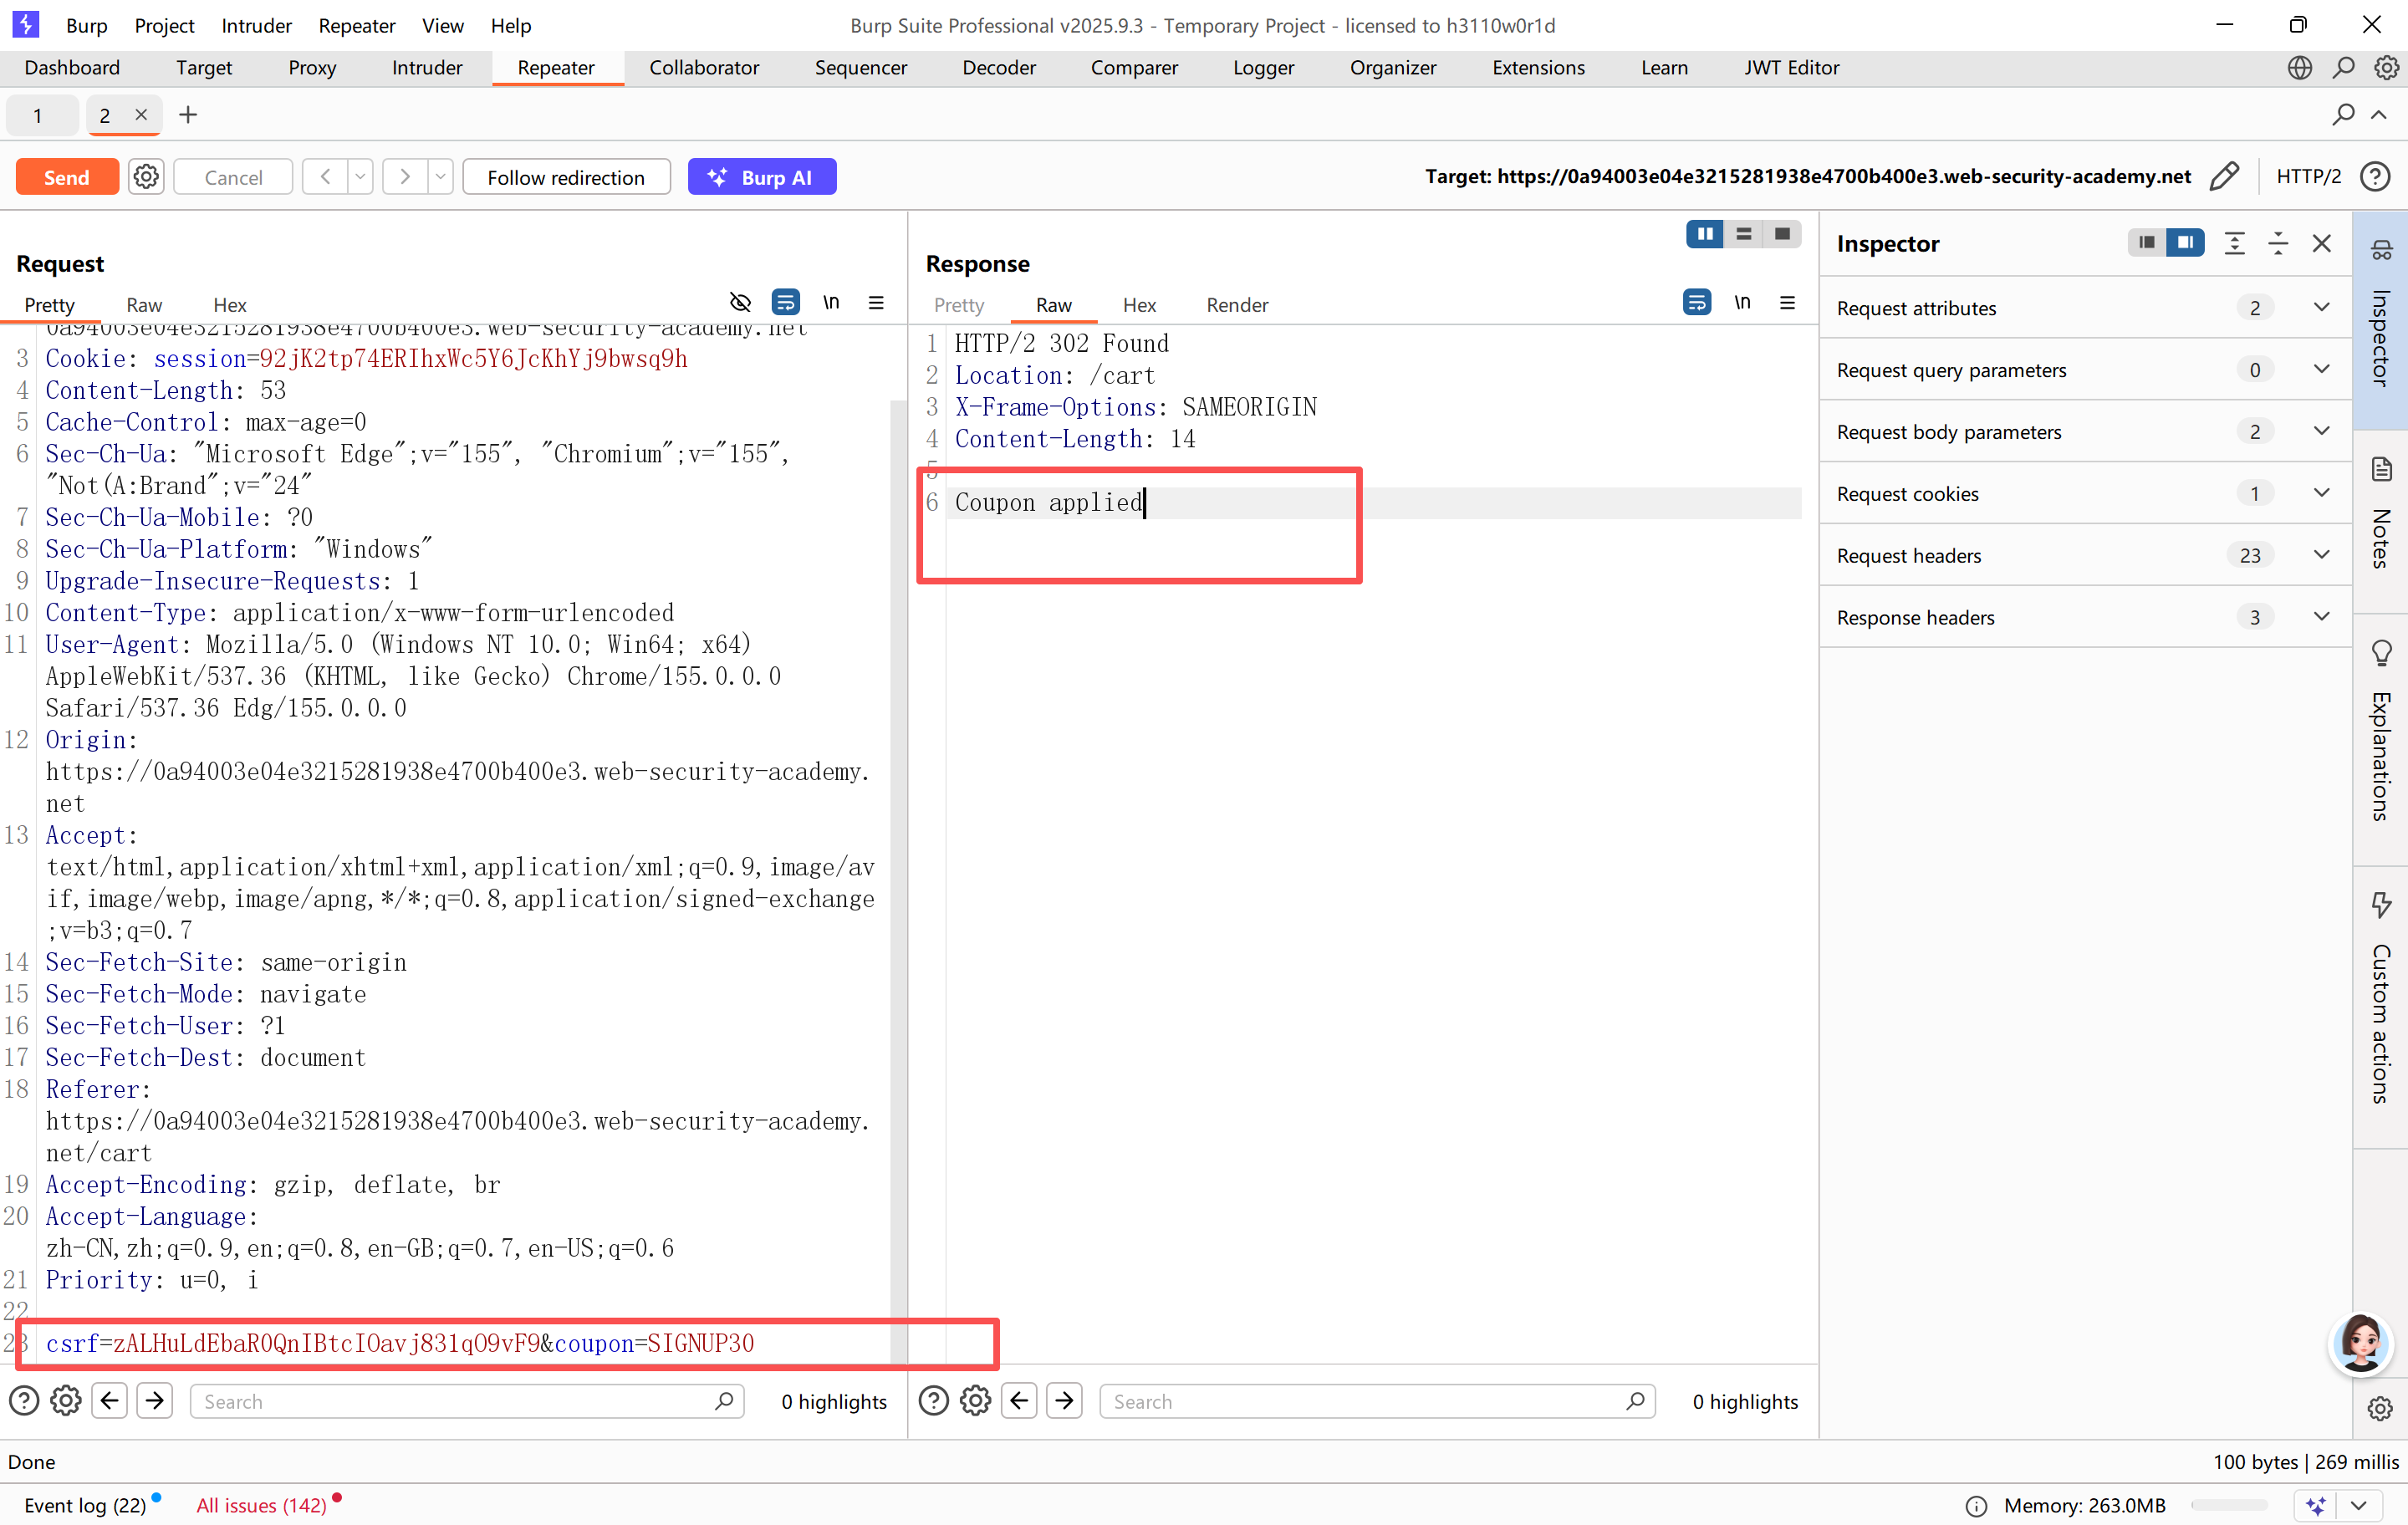
可以看到并没有对是否使用的校验
修复方案:
- 后端给每张优惠码绑定「是否已使用」的状态标记,使用后永久置为已使用。
- 每次使用优惠码时,优先校验该码的使用状态,而不是校验和上一次是不是同一个。
- 订单维度限制优惠码使用次数,而不是靠输入顺序判断。
实战快速识别:
优惠码、抵扣券、积分抵扣、抽奖次数这类功能,直接按这个顺序测:
- 同一张券连续用两次 → 看会不会拒绝
- 用 A→用 B→再用 A → 看能不能绕过
- 抓包重放优惠请求 → 看后端有没有真正的「已使用」标记校验
所有带「次数限制」「去重校验」「频次控制」的业务功能,都可能出现同款逻辑错误:
兑换码、抵扣券、邀请码
每日签到、抽奖次数、福利领取
短信验证码发送次数限制
投票、点赞的频次限制
会员每日权益次数
只要开发把「总次数 / 全局去重」做成了「连续 / 相邻限制」,就能用「交替、间隔」的方式绕过。
场景:整数溢出
漏洞原理:
1. 计算机整数的存储限制
程序里的数字不是无限大的,是用固定长度的二进制空间存储的。最常见的32 位有符号整数(int),取值范围是:
(-2^{31} \sim 2^{31}-1) 也就是 -2147483648 到 2147483647。
当数值超过最大值 2147483647 时,就会发生上溢—— 数值会像钟表过了 12 点一样,绕回最小值,变成负数;反过来低于最小值就会下溢变成正数。
2. 购物车场景的溢出逻辑
购物车总价公式:总价 = 商品单价 × 商品数量
- 正常逻辑:数量是正整数,总价为正,积分足够才能购买。
- 漏洞逻辑:后端用 32 位有符号整数计算总价,完全没做数值边界校验。当数量大到「单价 × 数量 > 2147483647」时,计算结果溢出,直接变成负数。 总价为负,就相当于系统 “欠你钱”,结算时不仅不扣钱,还相当于抵扣了全部金额。
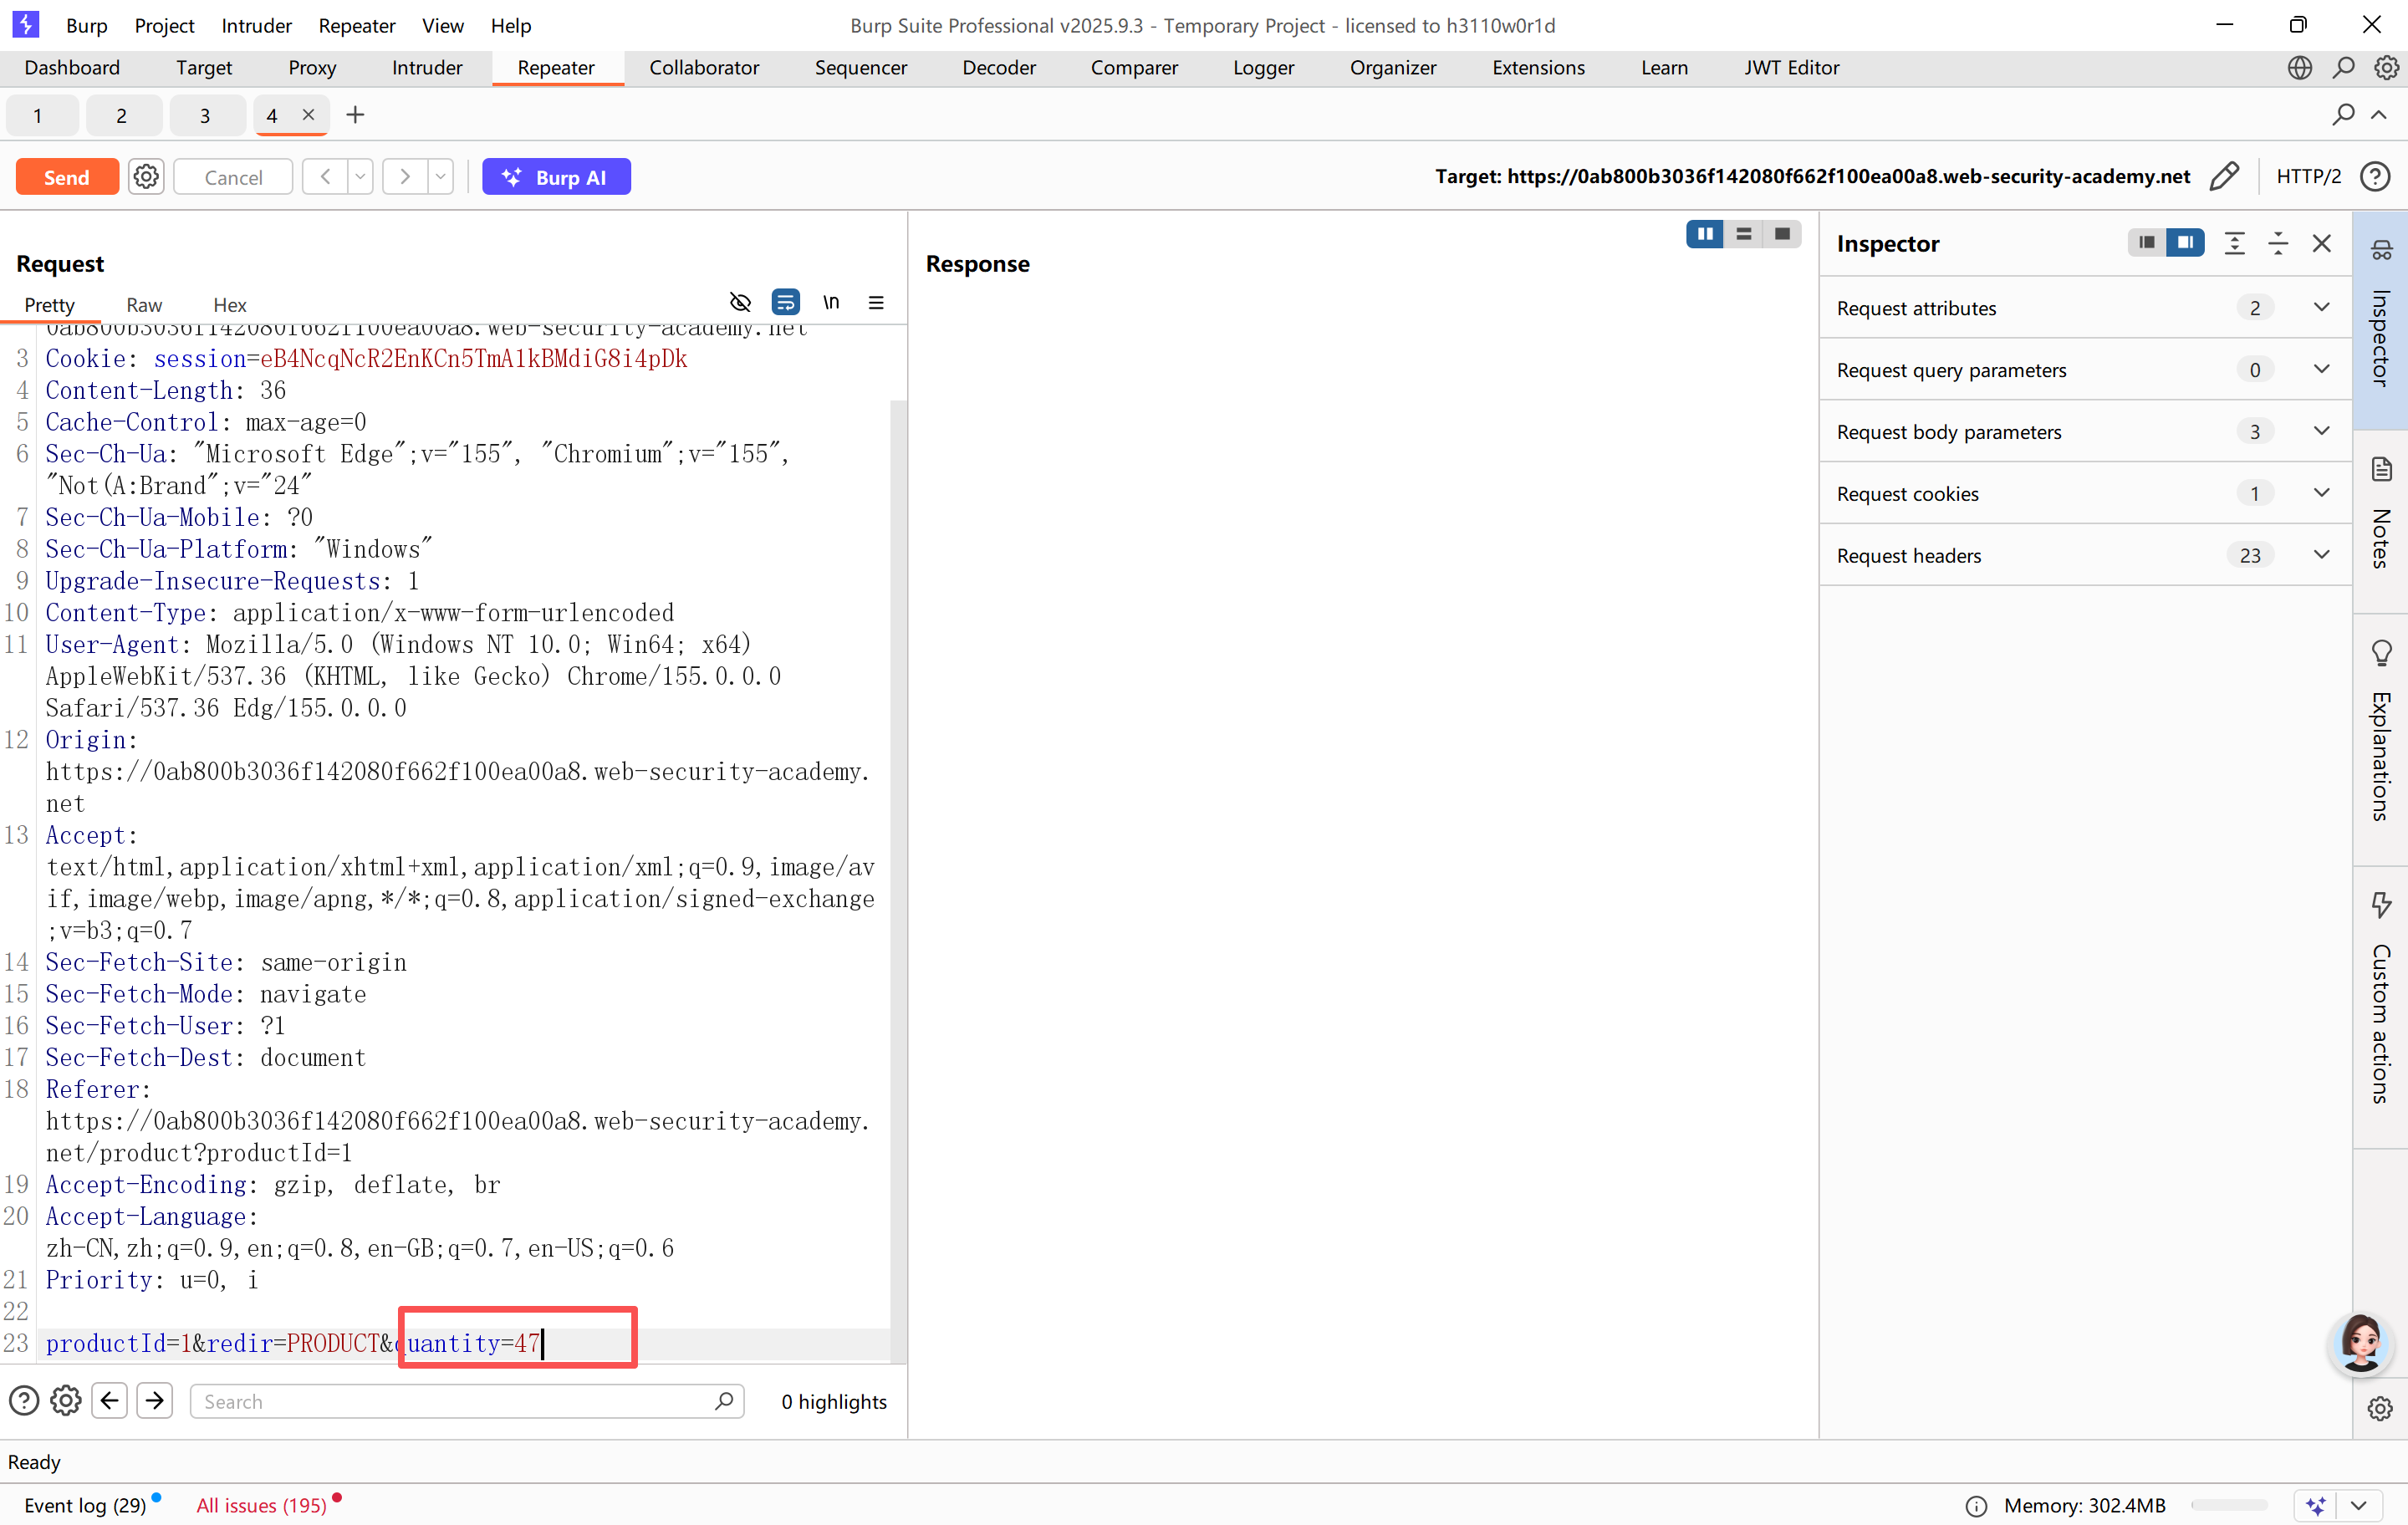
加入购物车这一步,99能传,100被限制
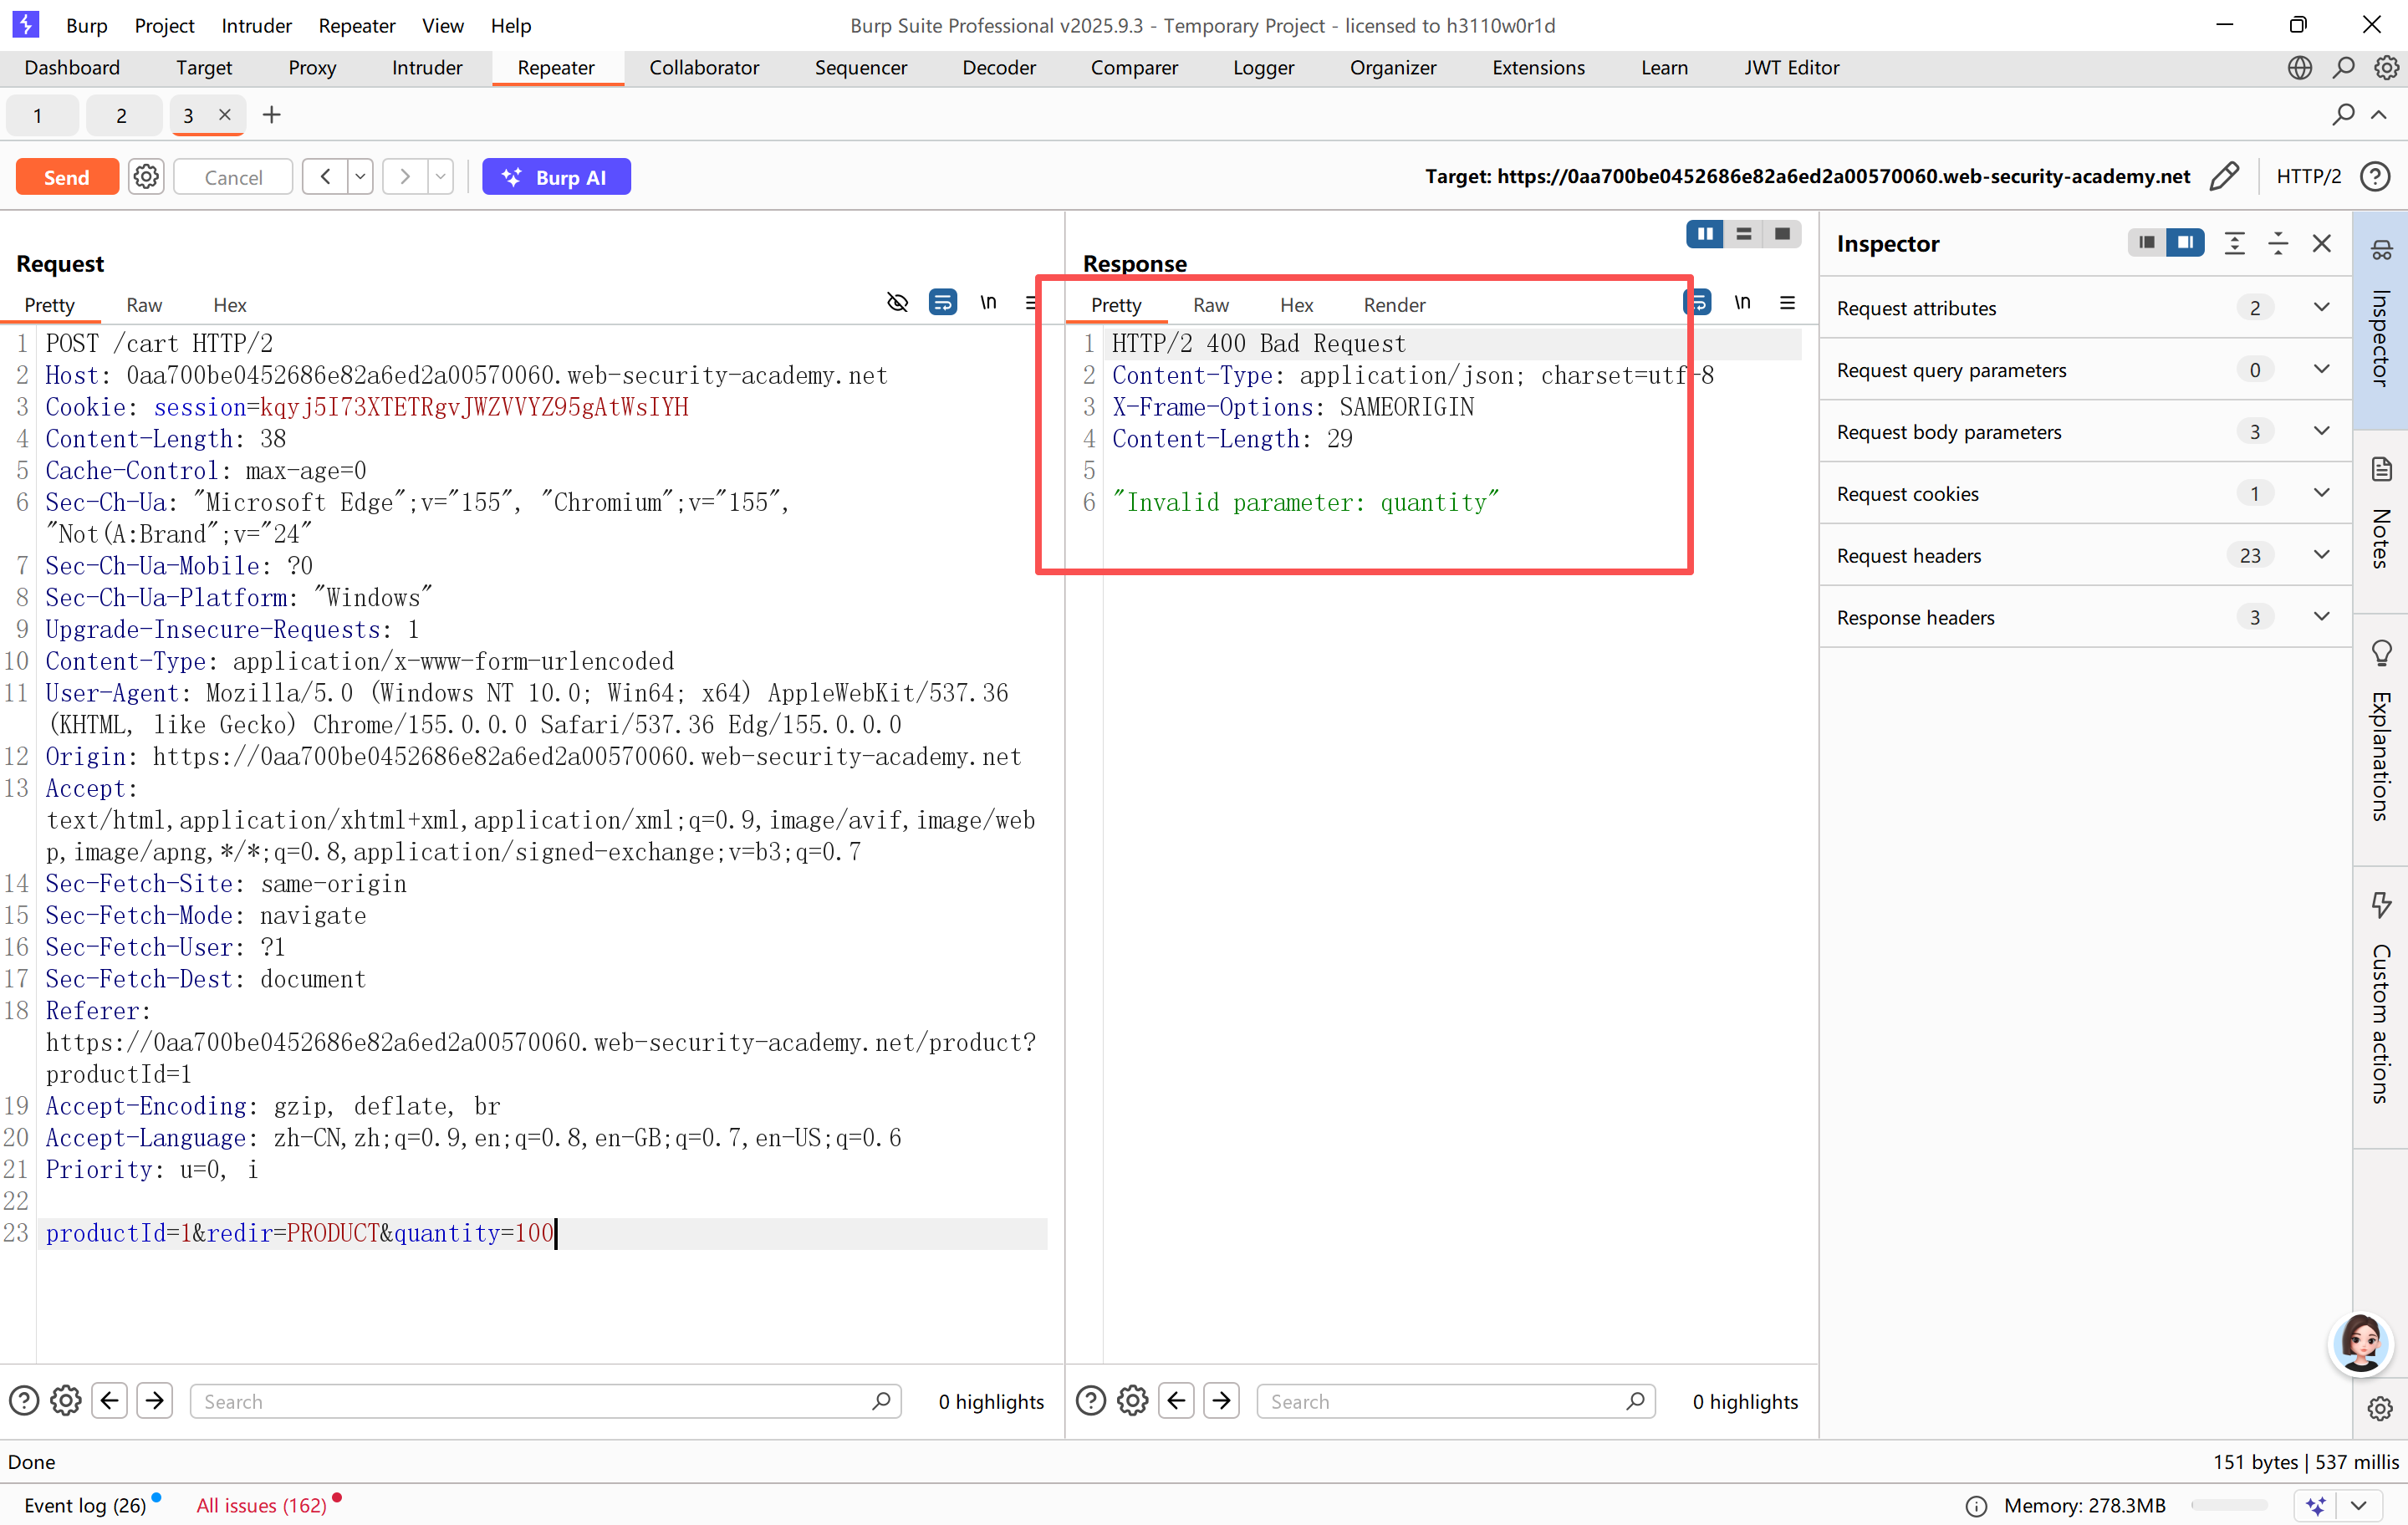
但是会跟前面传过的参数叠加
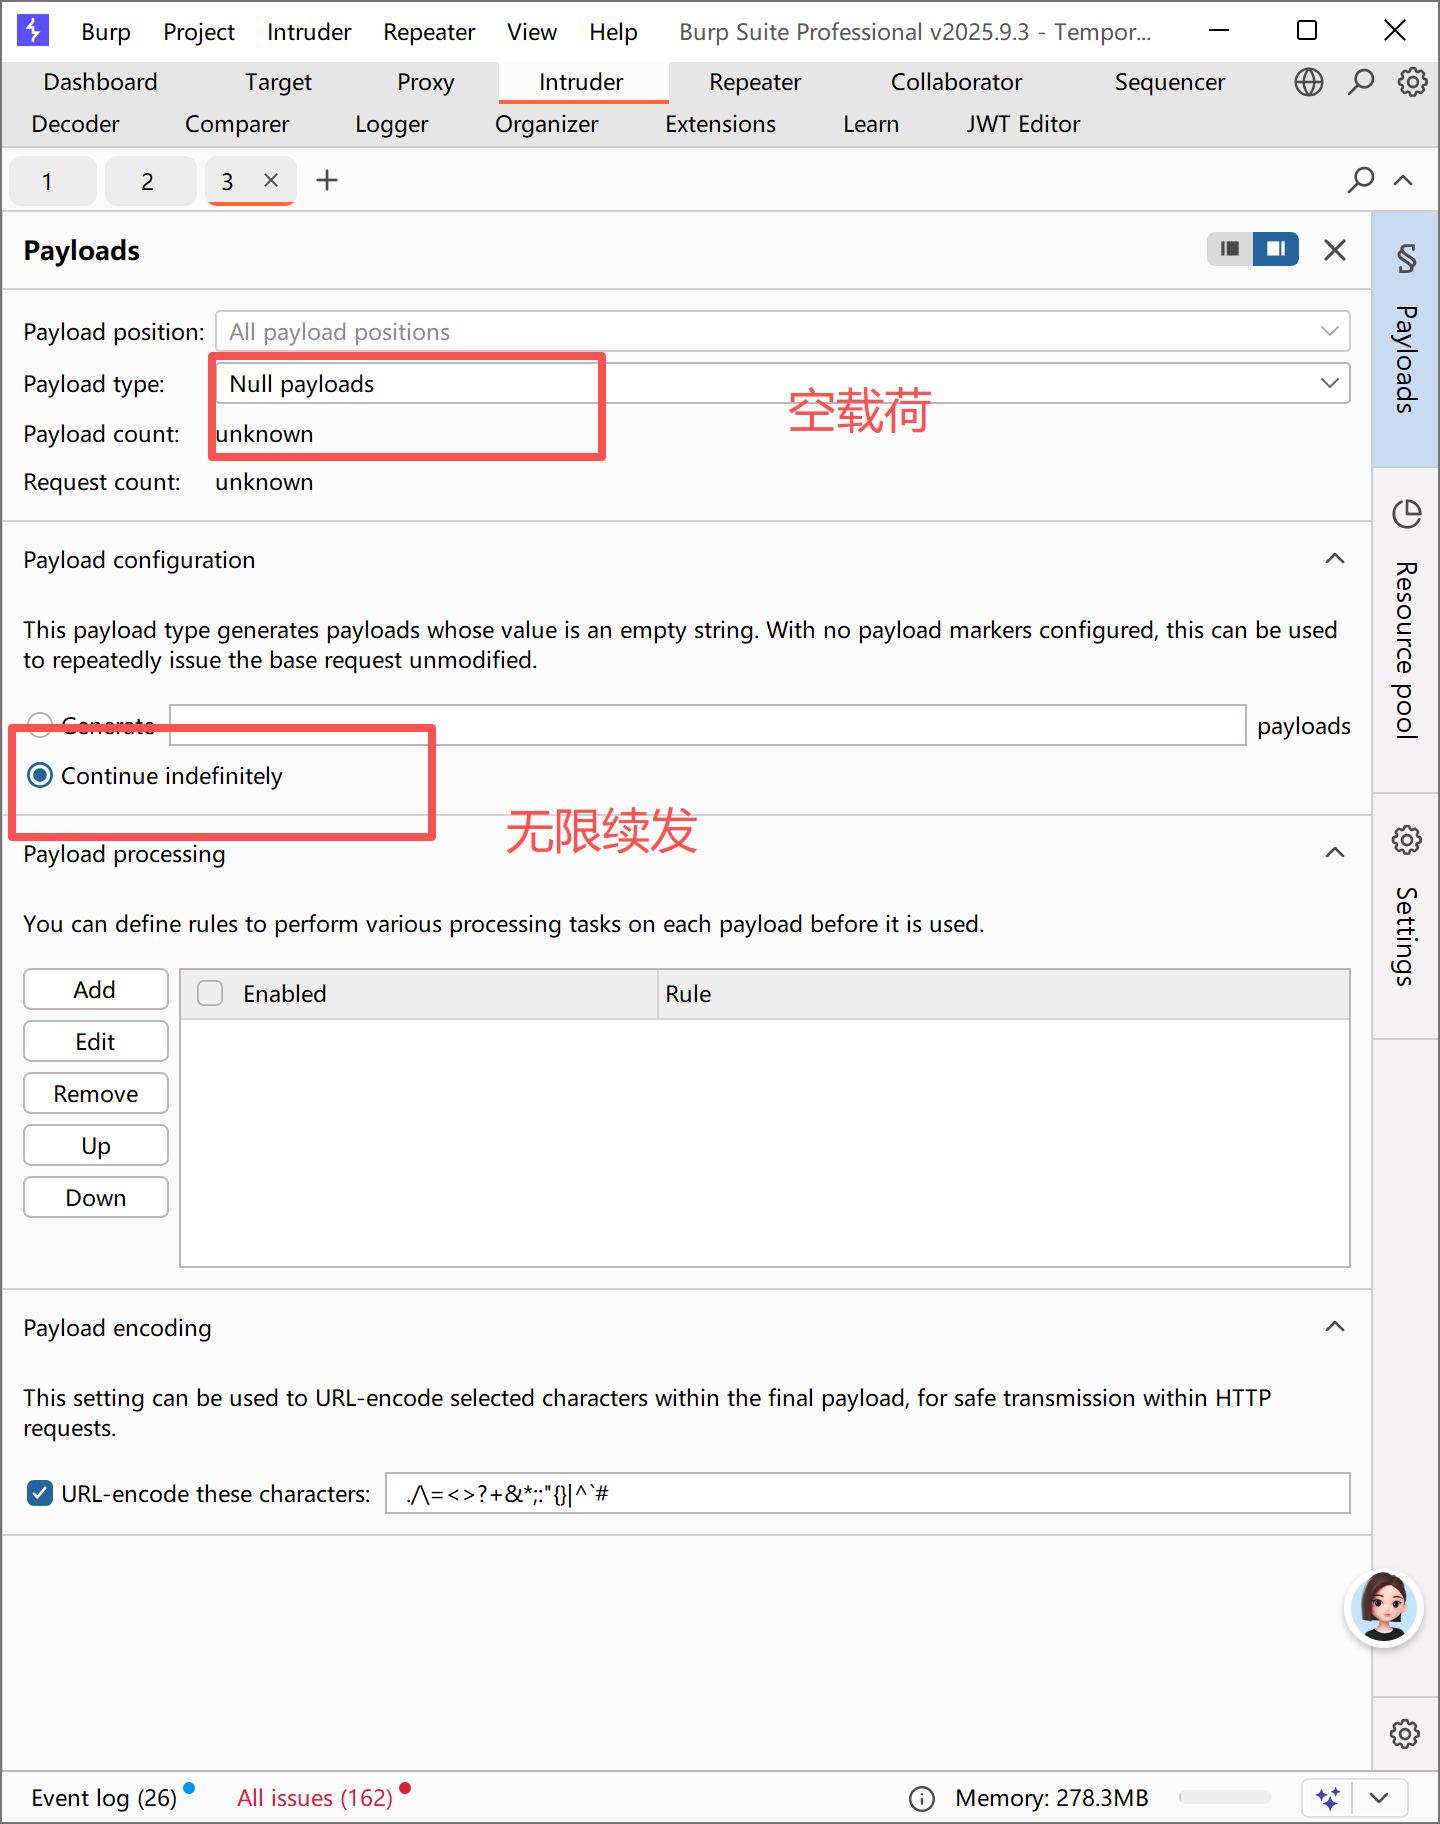
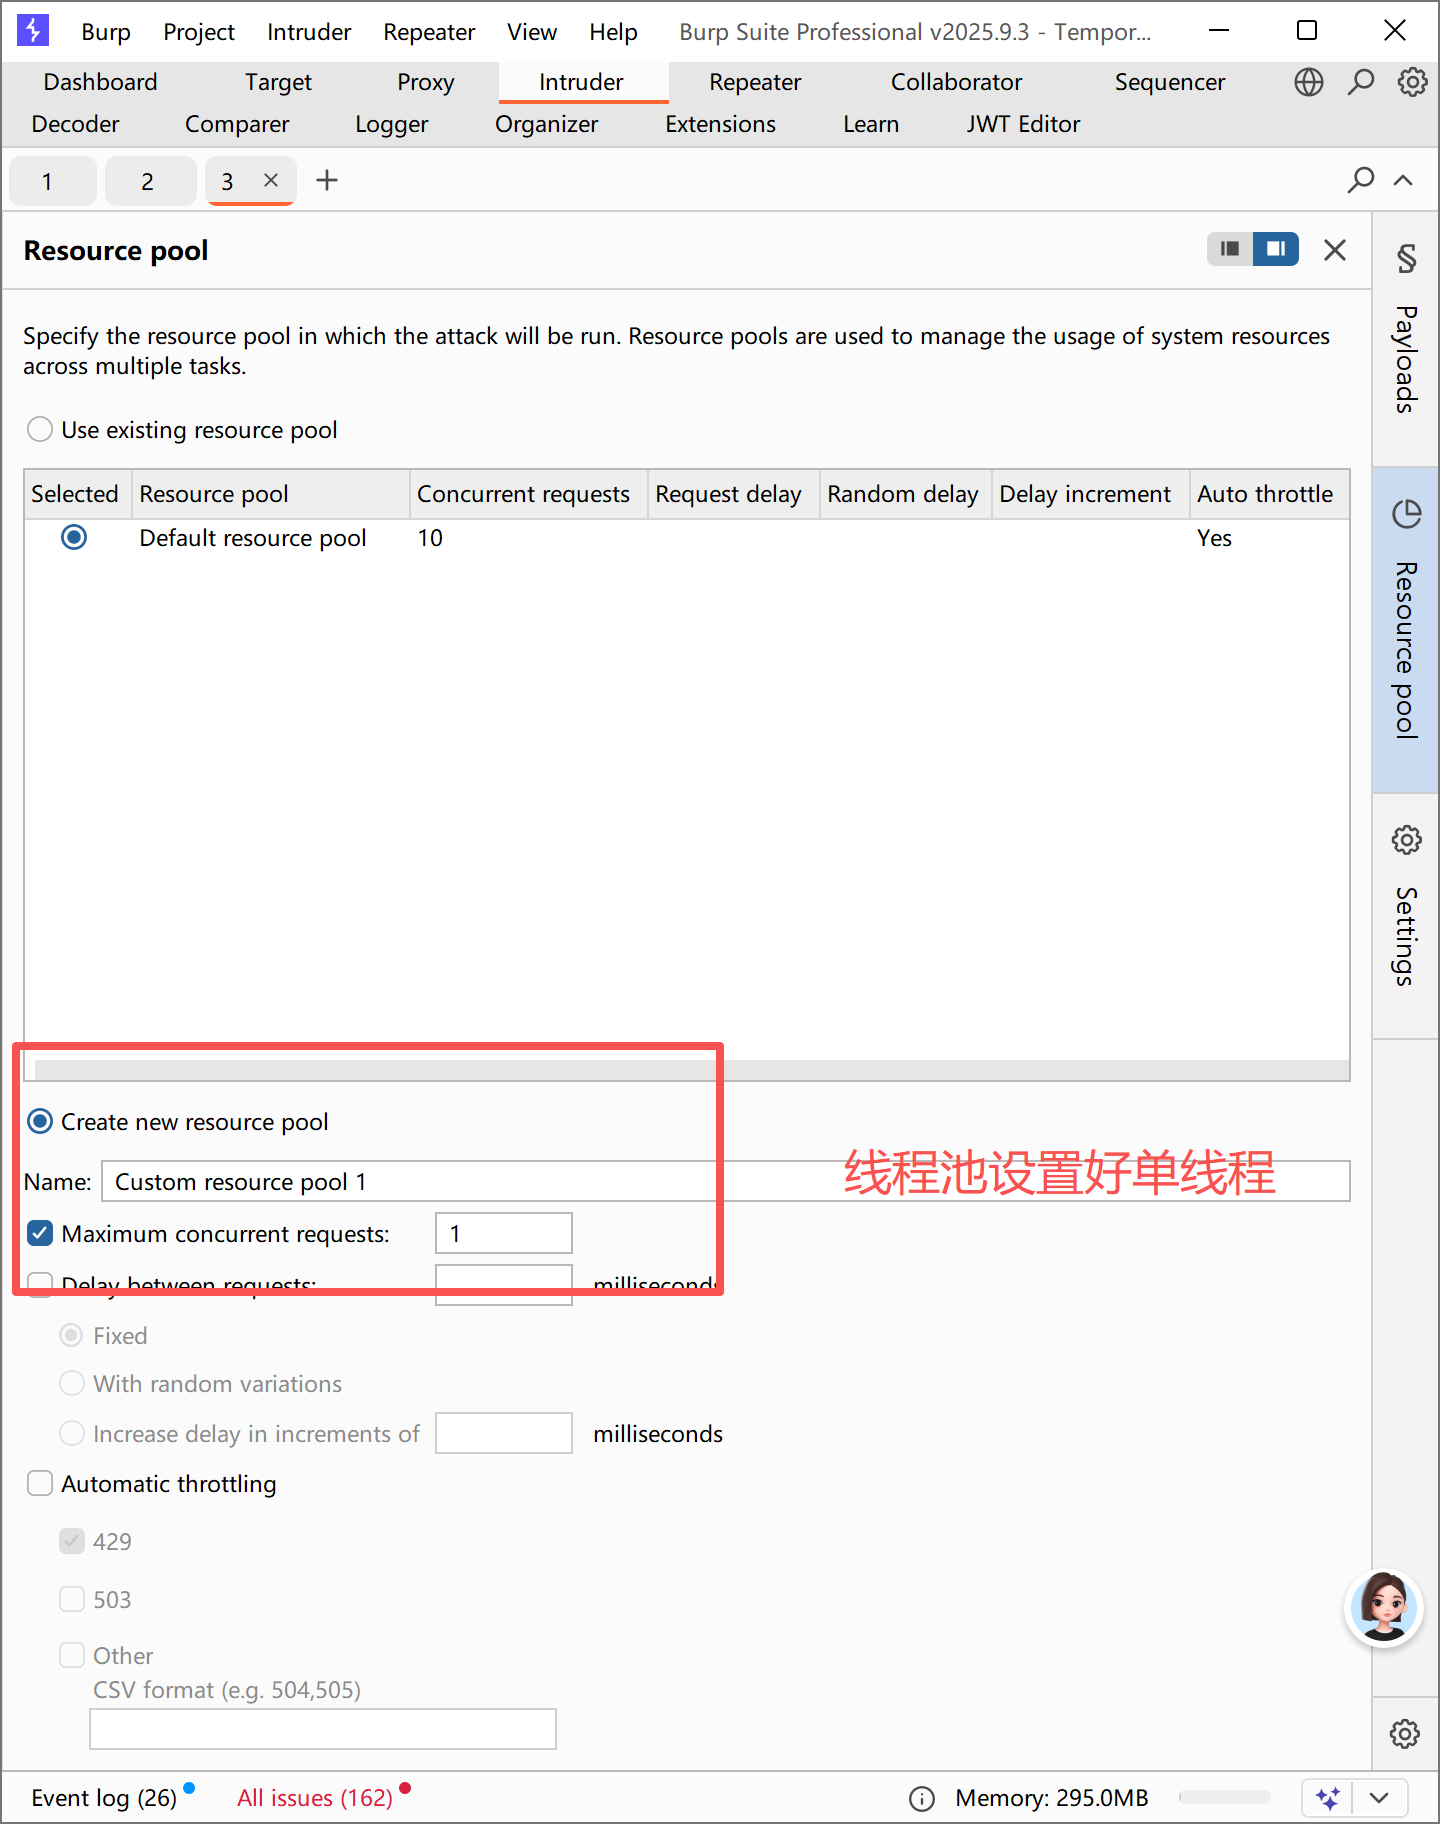
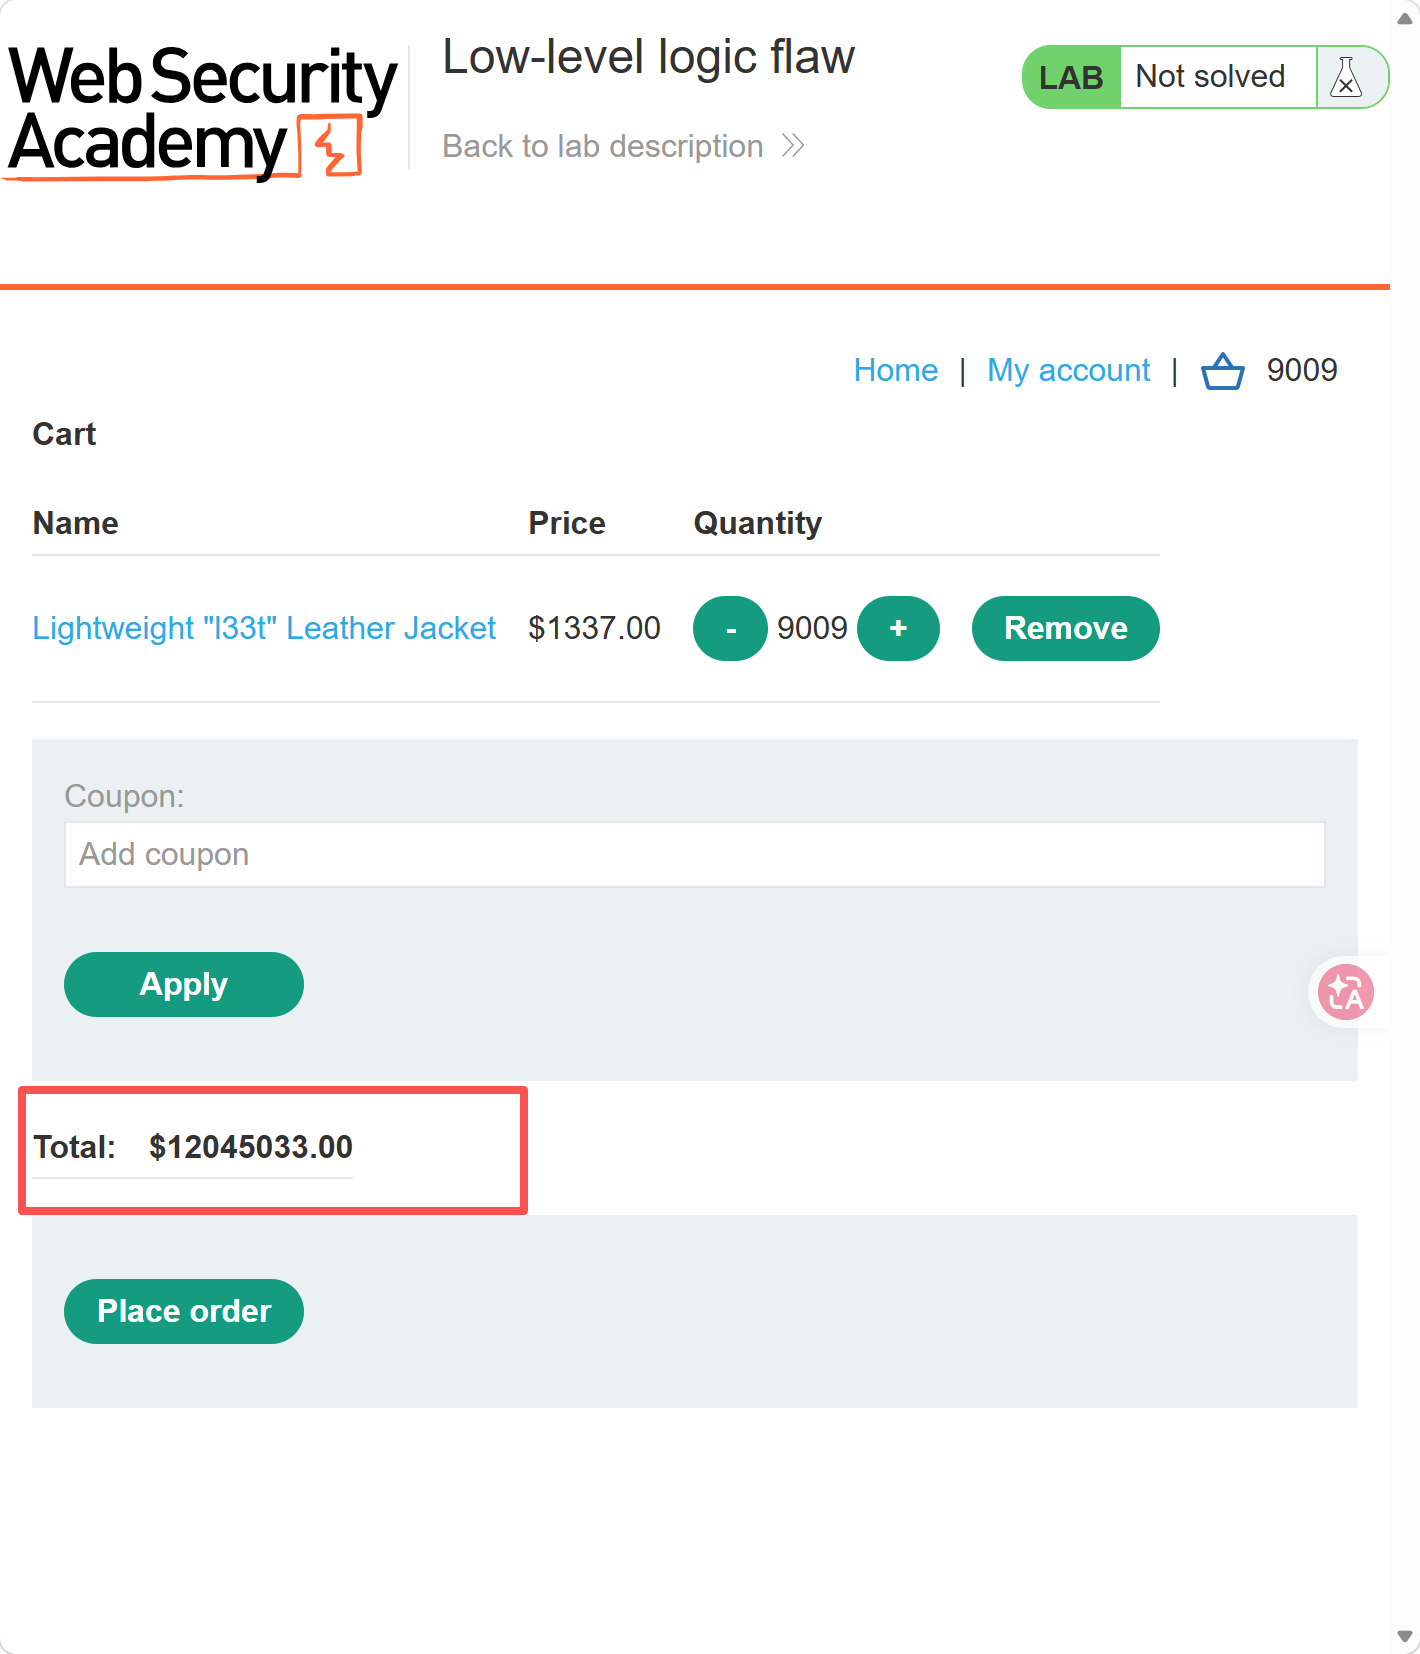
可以看到一开始是整数,后面超范围后变为负数
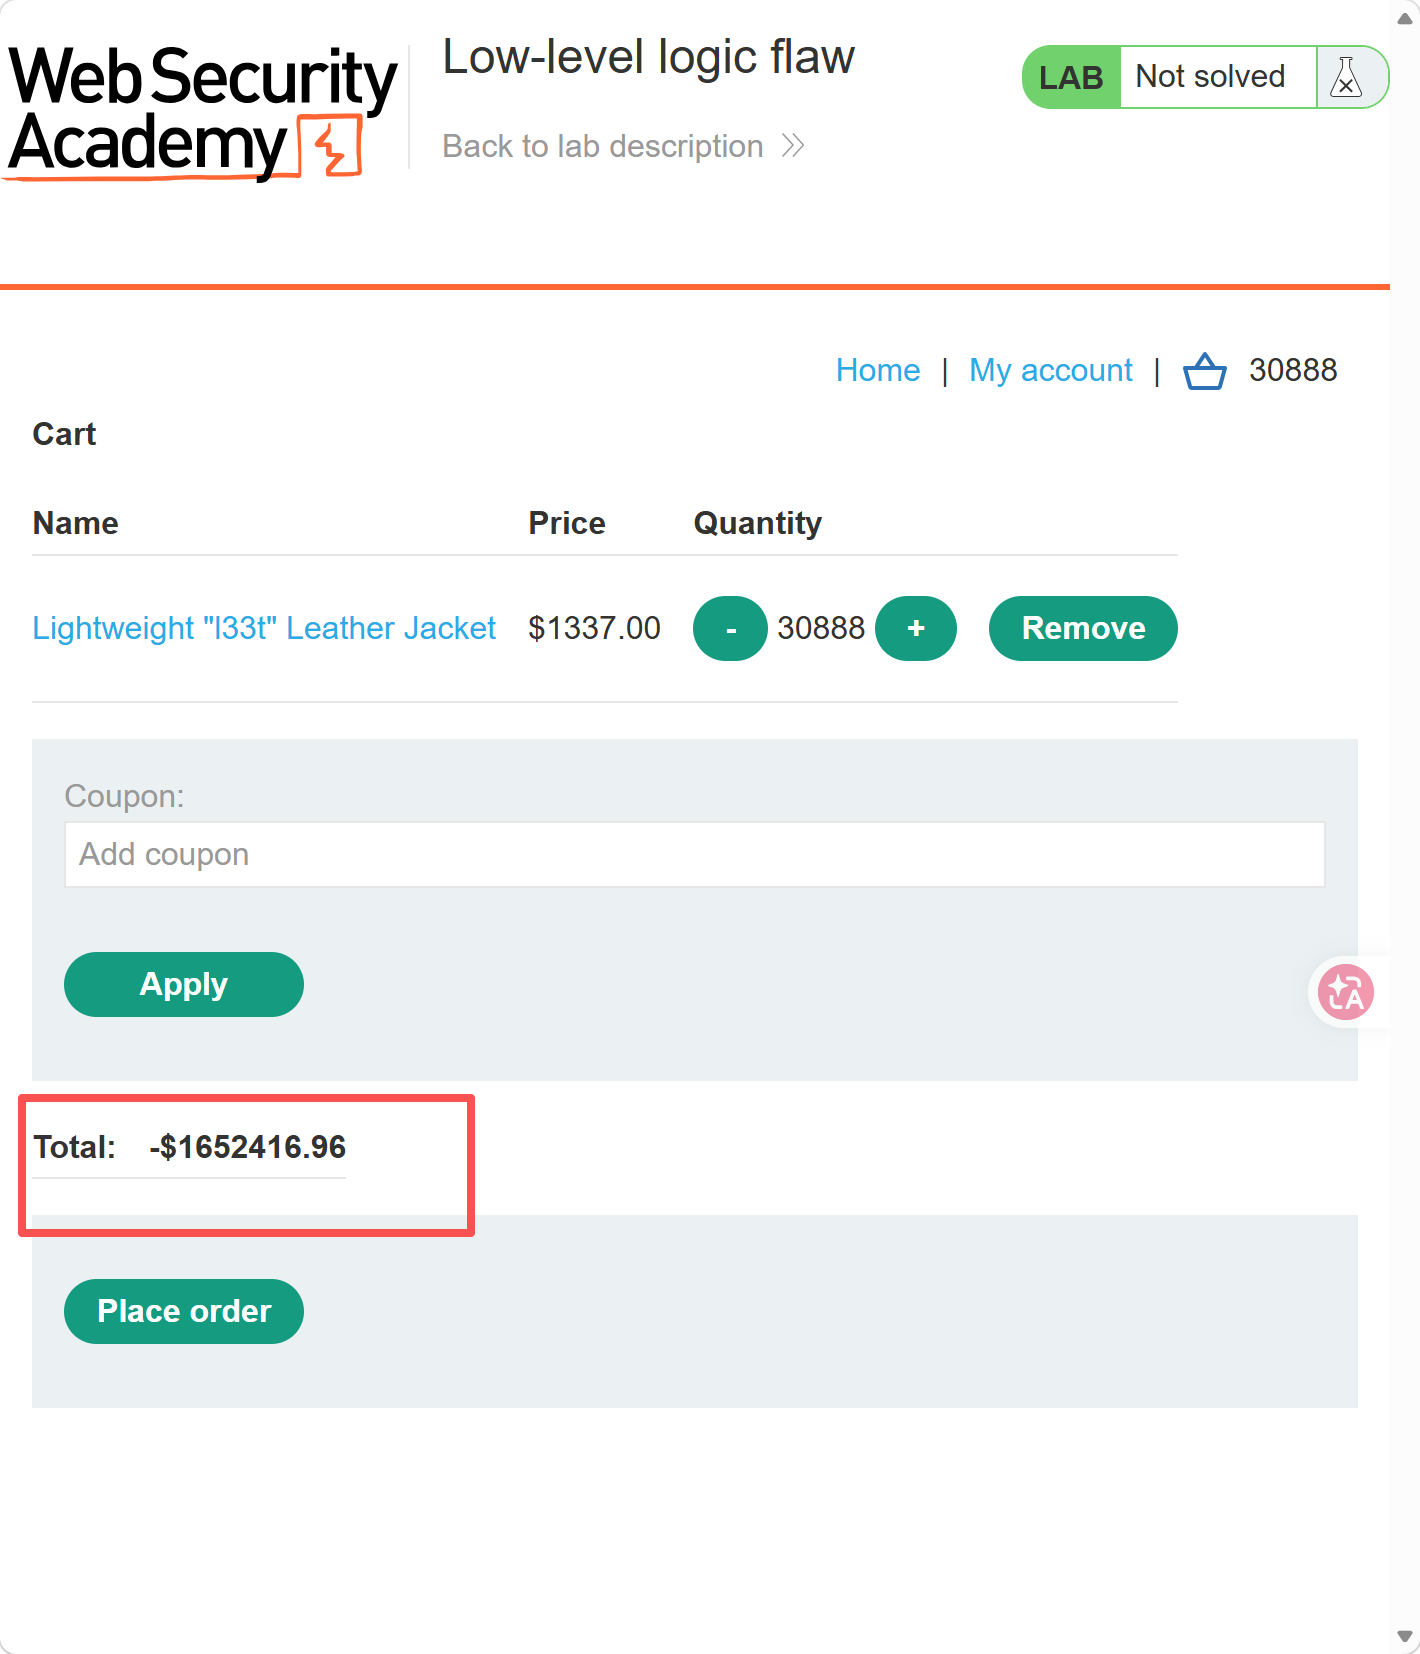
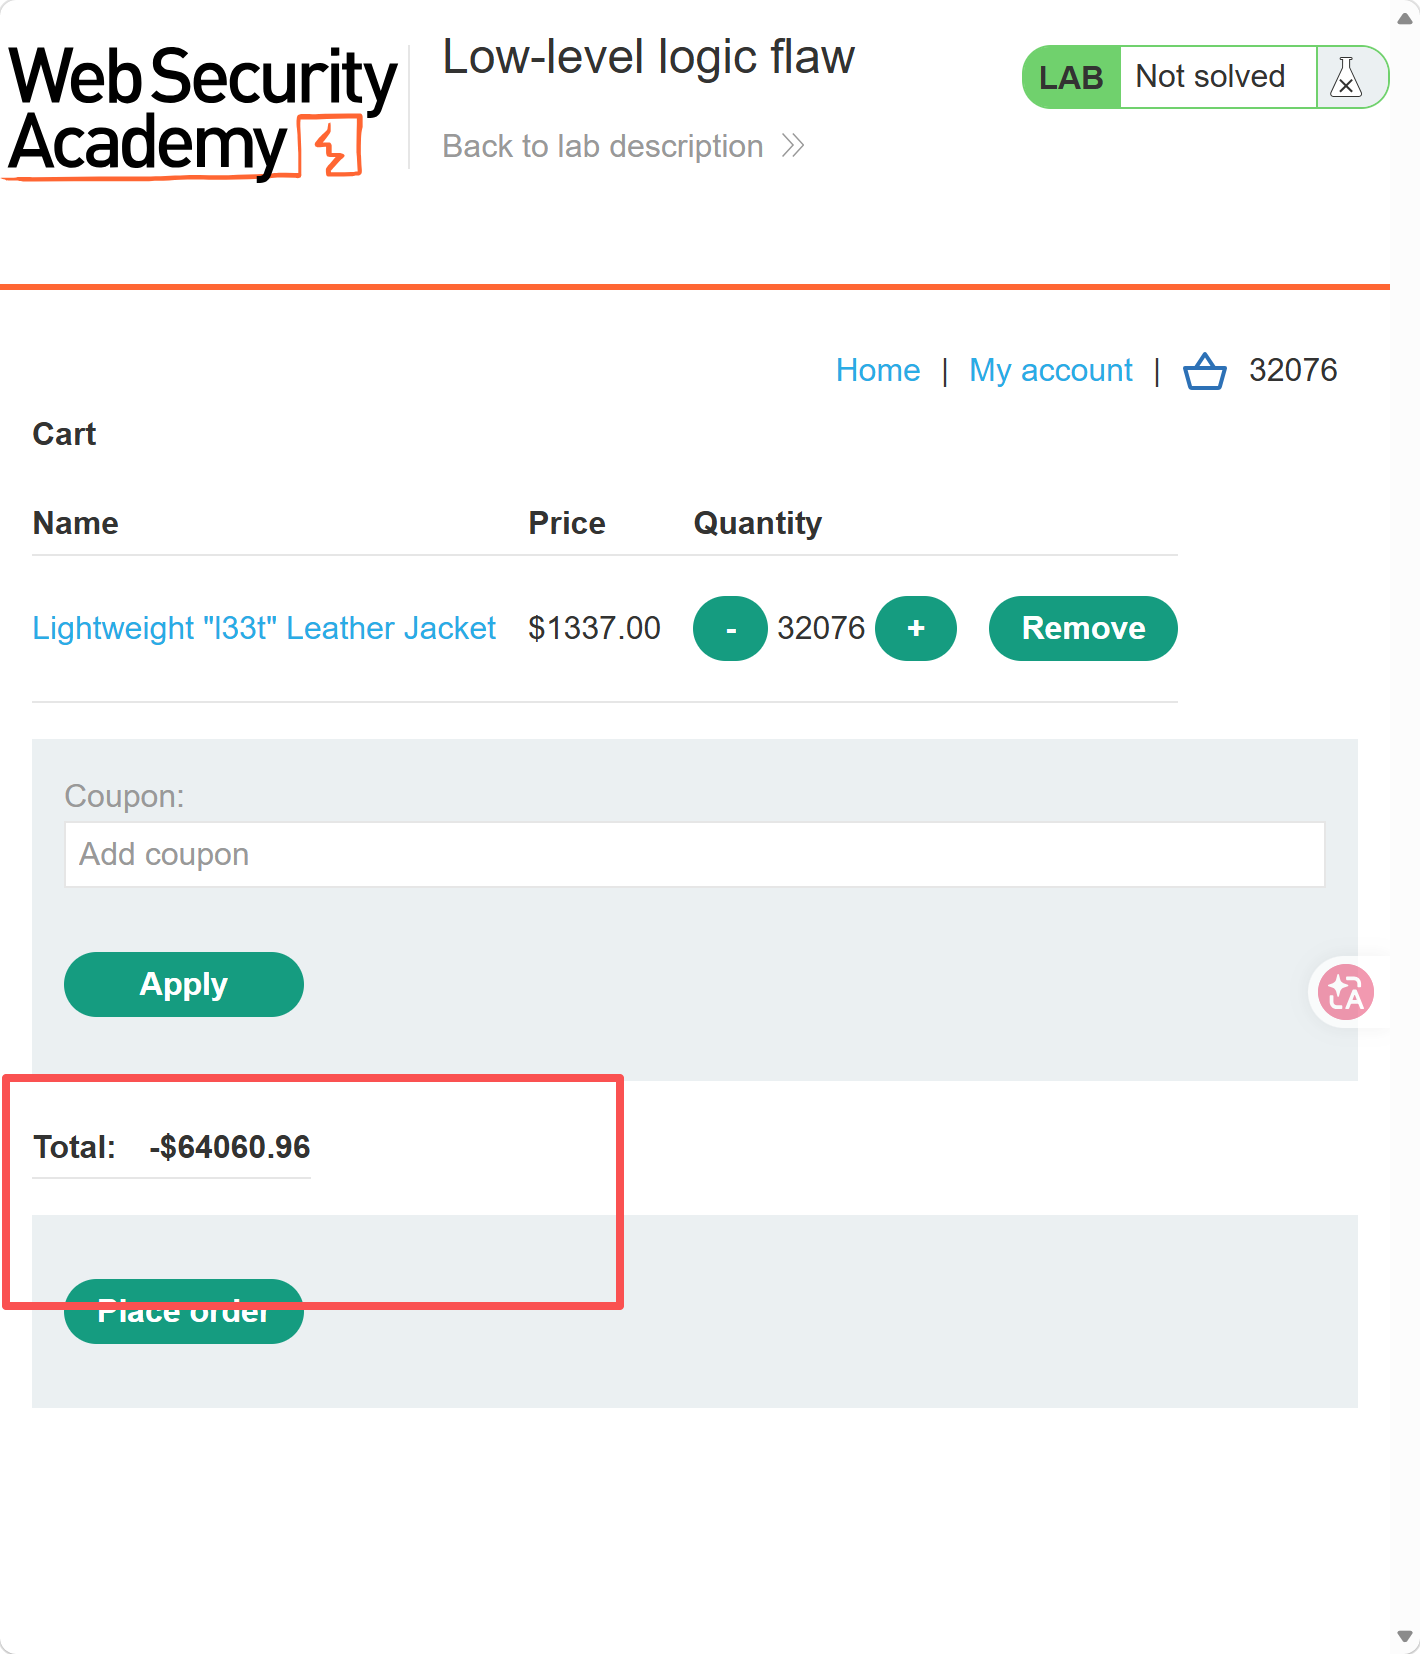
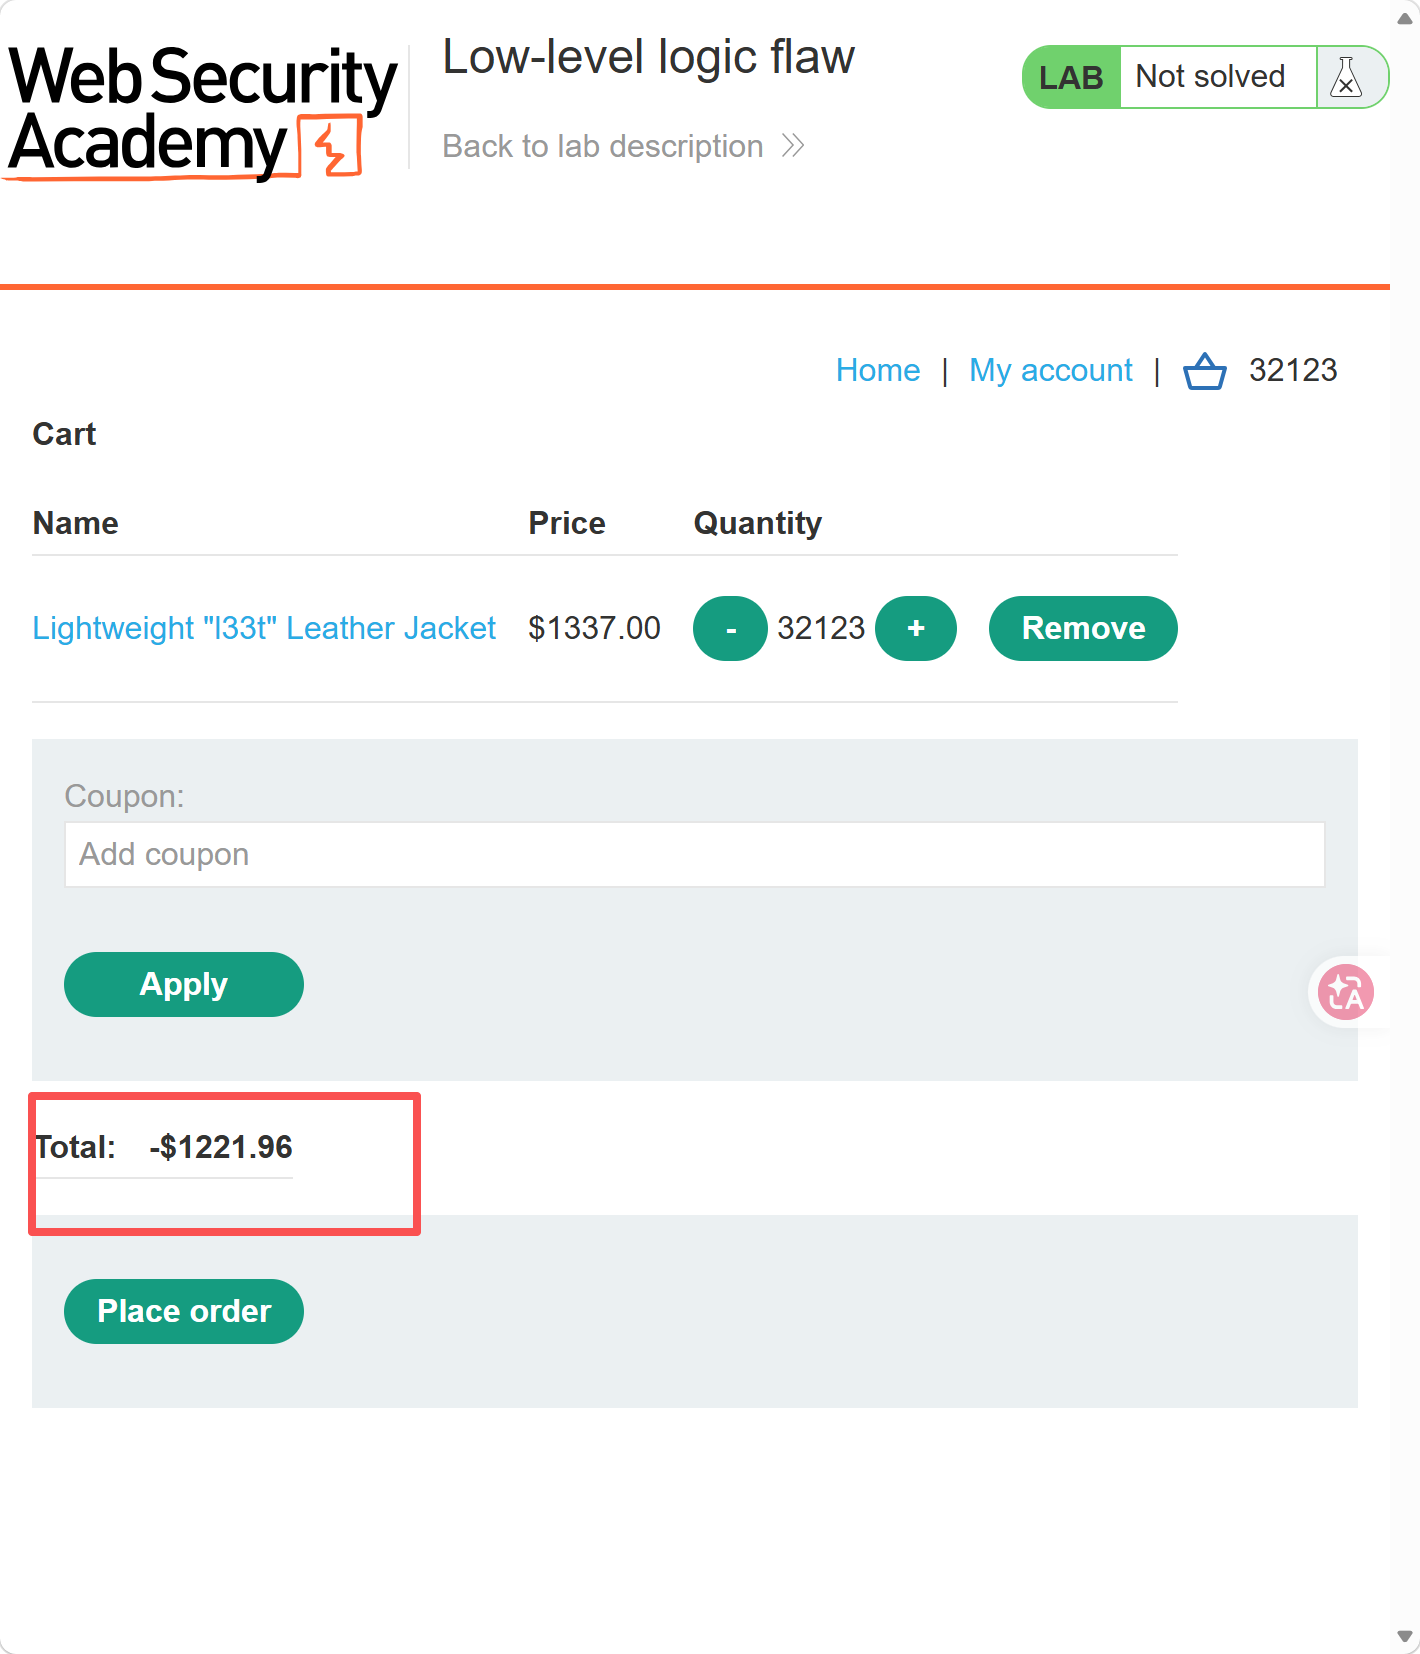
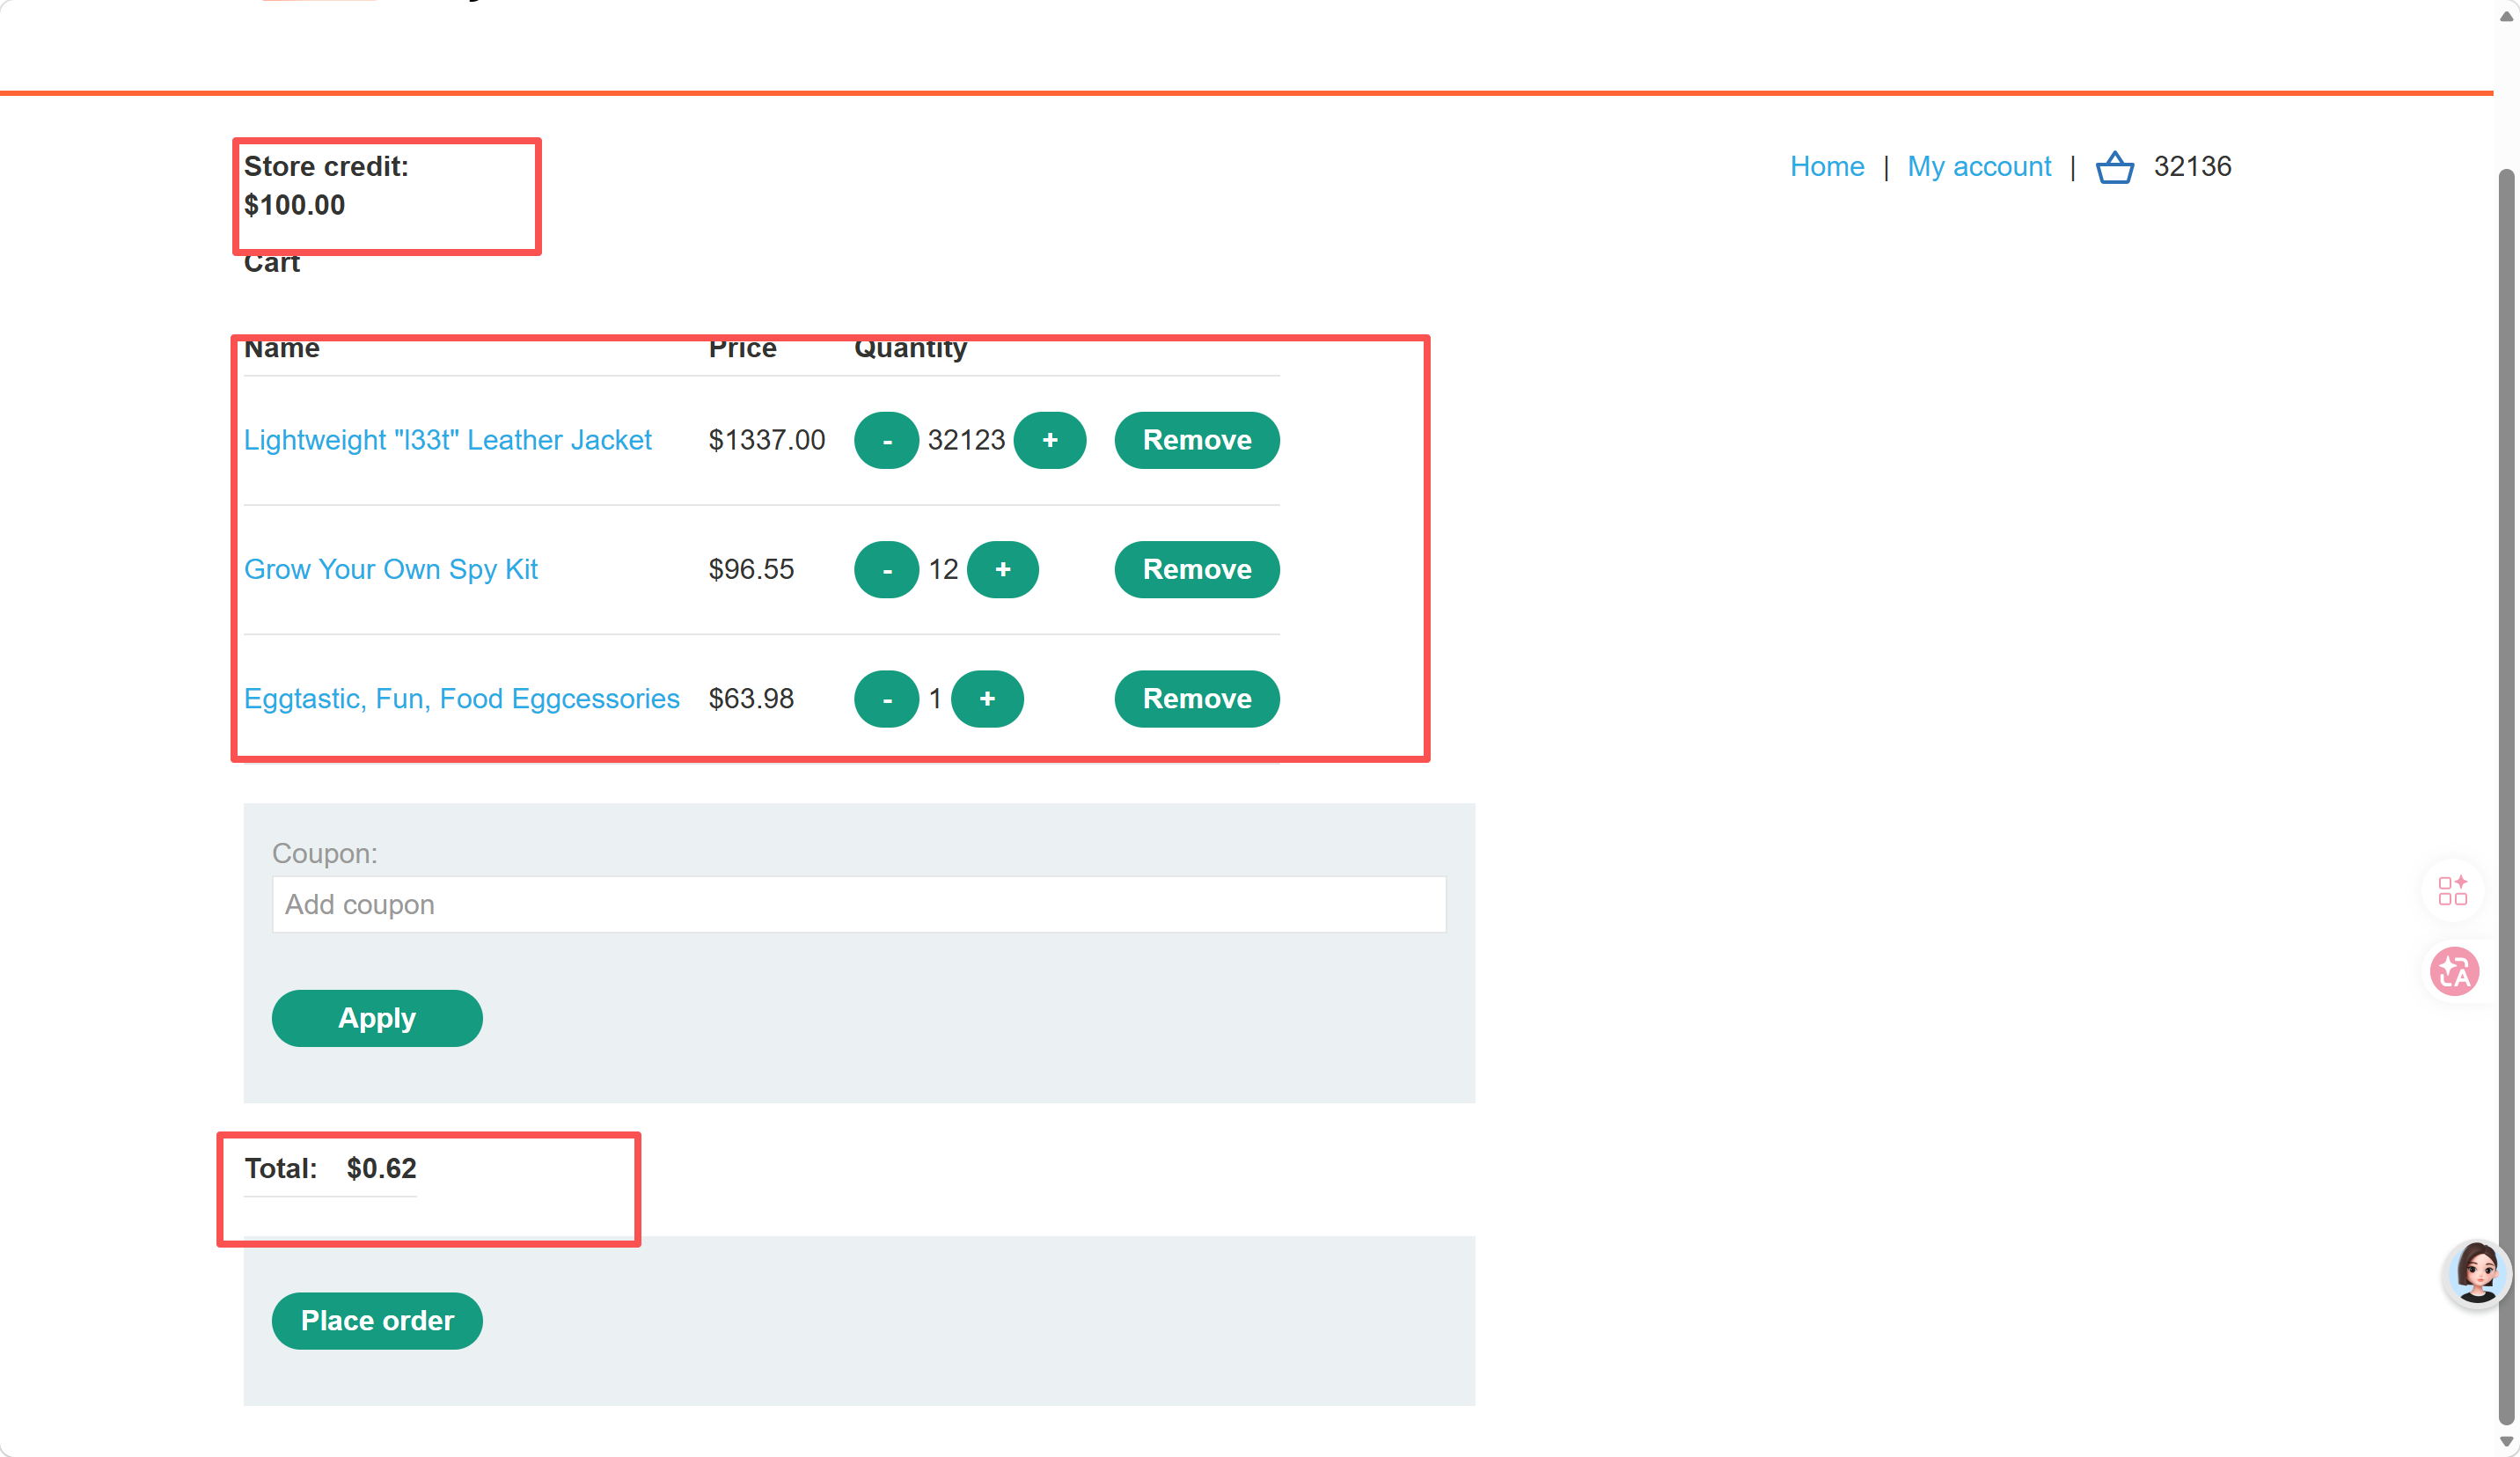
然后我们可以再计算之后凑一些单价低的商品,将总价凑回正数,并且用一个不可思议的低价购买。
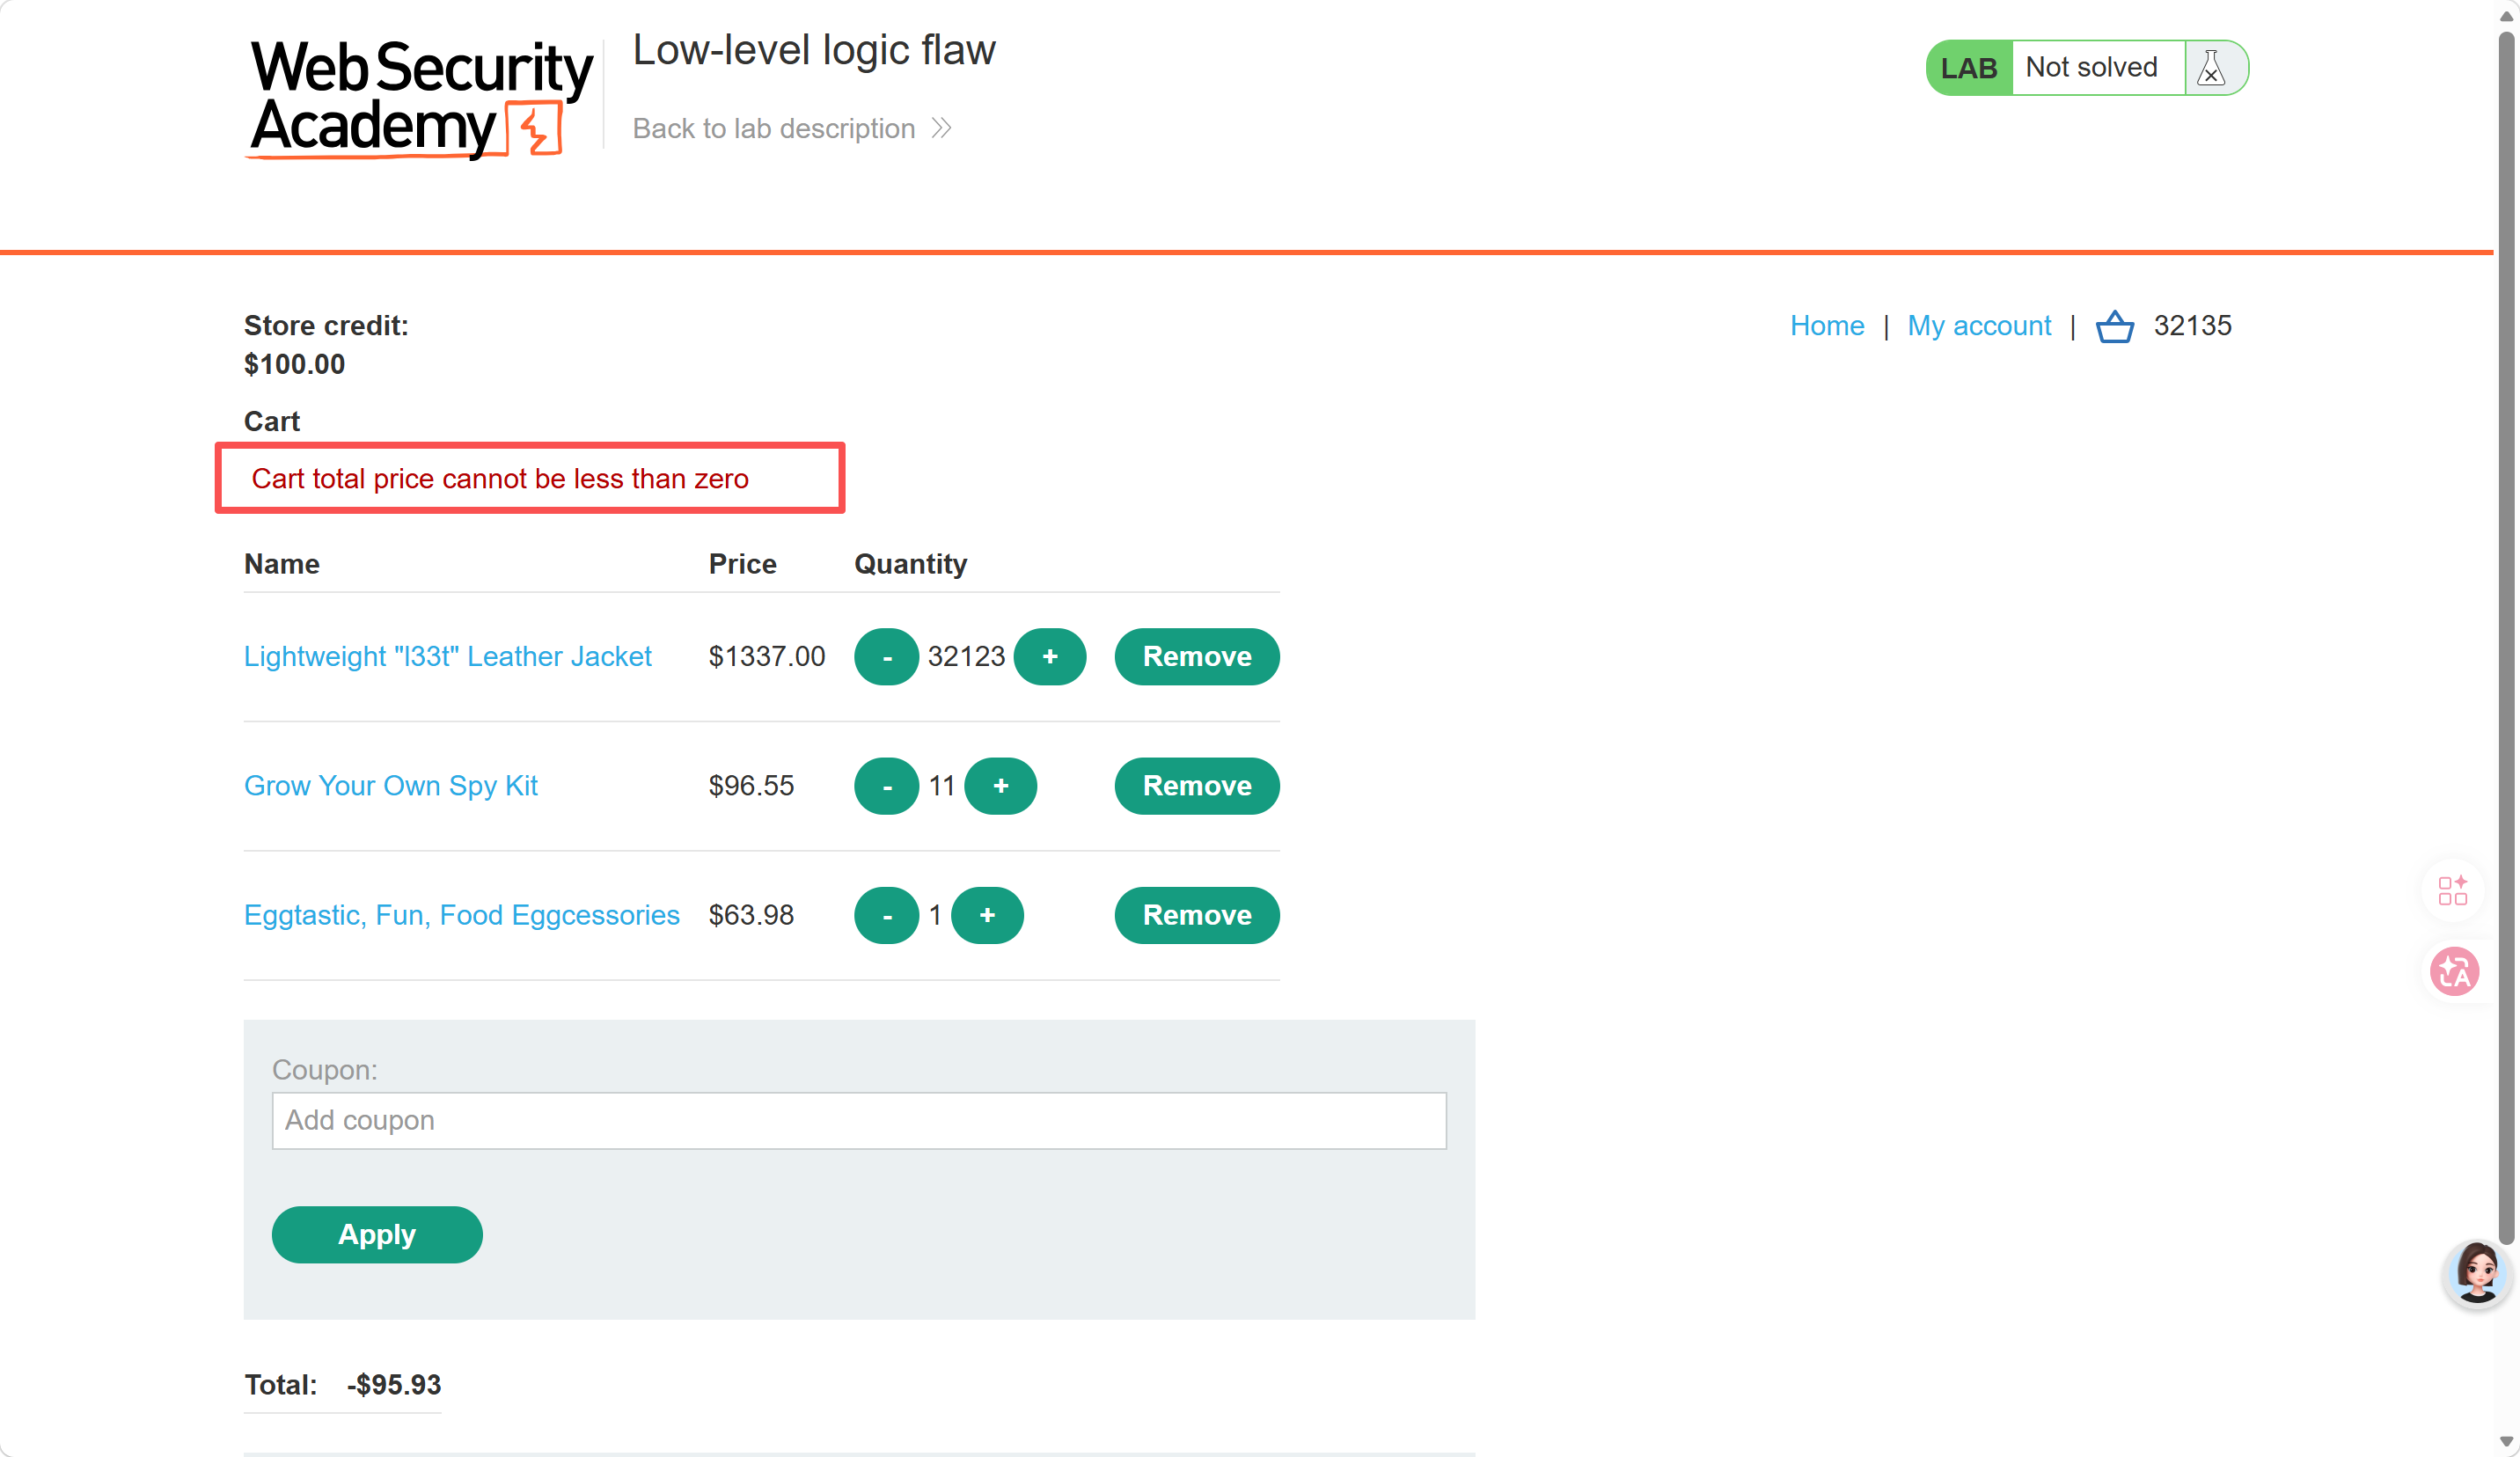
当然我也尝试过直接用负数结算,显而易见是不行的,这里做了负数校验
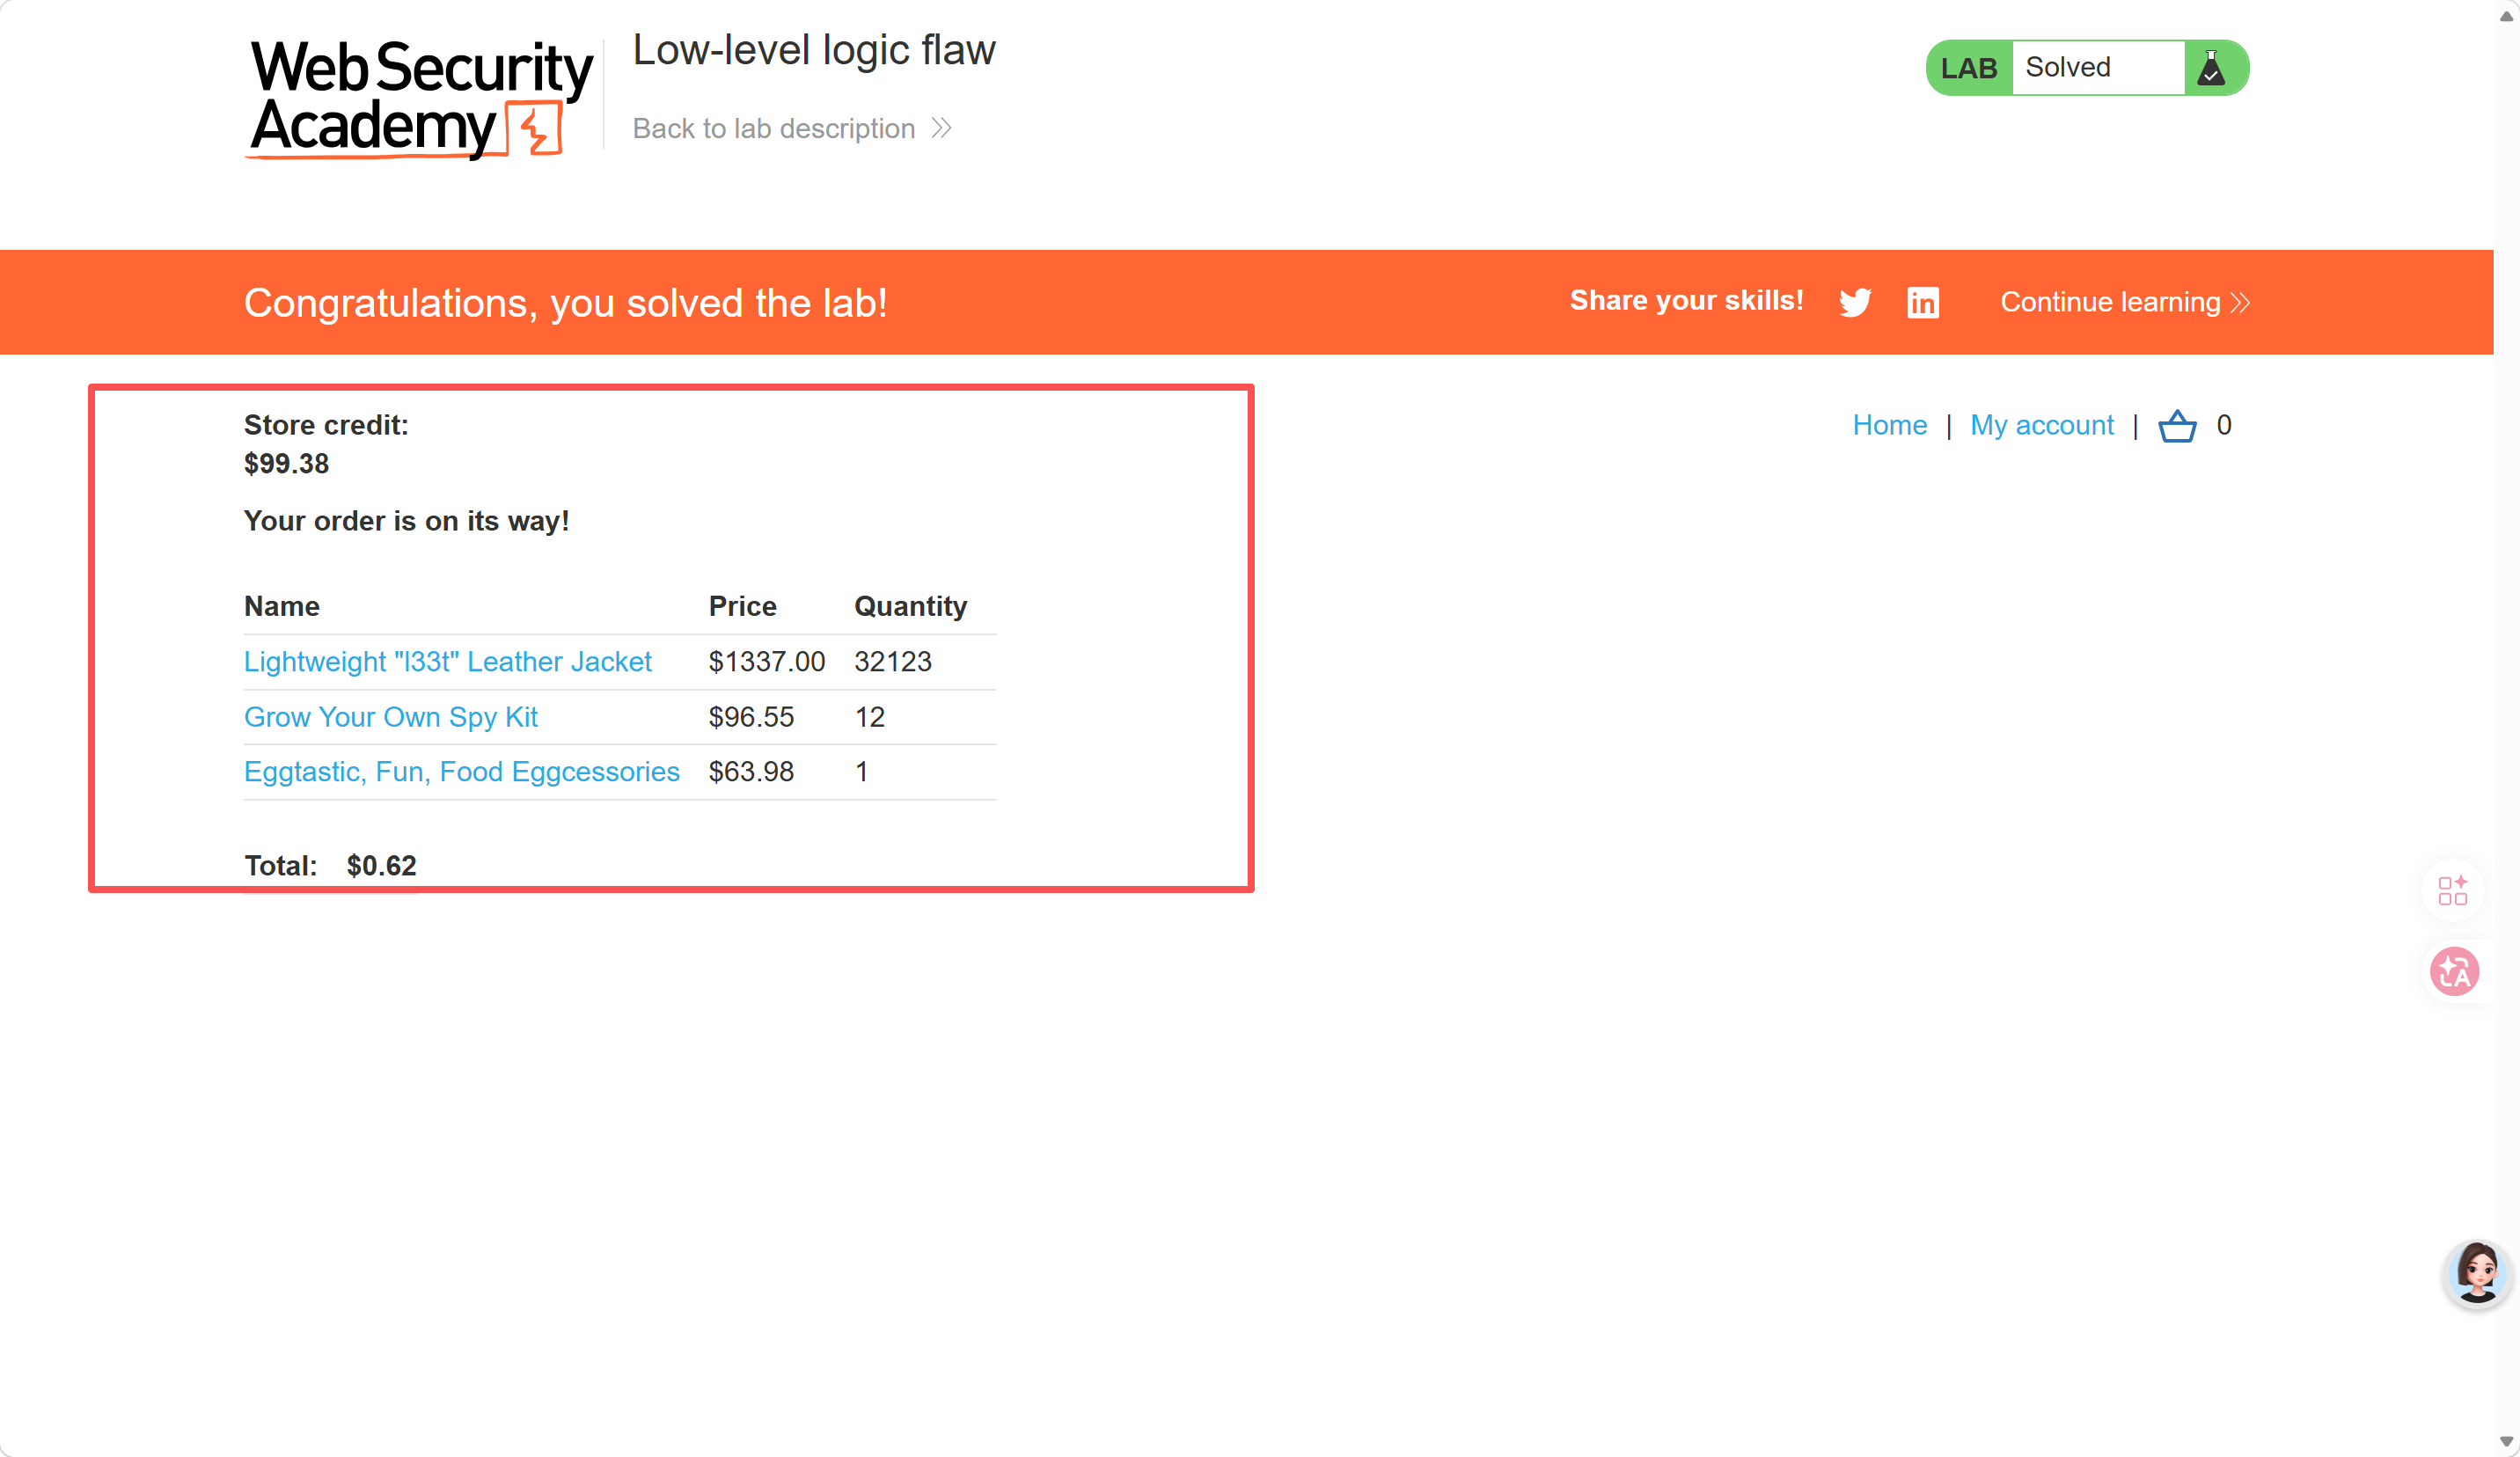
溢出过程:
总价 = 商品单价 × 数量,底层是用整数「美分」来计算的(避免小数误差),所以:
- 正常上涨阶段:数量增加,总价稳步上升,都是正数;
- 临界点溢出:当总价超过最大值
2147483647(约 2147 万美元)时,二进制的数值位进 1,顶到了符号位,符号位从 0 变成 1,数值直接跳转到最小值 -2147483648; → 这就是你看到「突然变成一个很大的负数」的原因 —— 刚溢出的时候,直接从正最大值跳到负最小值,所以绝对值特别大。 - 负数上涨阶段:继续加数量,总价就从
-2147483648开始往上涨:-2147483647、-2147483646…… 负数的绝对值越来越小,越来越接近 0; - 穿过零点:继续加,总价会穿过 0,重新变成正数,继续上涨;
- 再次溢出:涨到正最大值后,又跳回负最小值,无限循环。
通用场景:
只要是数值计算的业务,都可能出现同类问题:
- 电商购物:总价溢出变负,0 元甚至负价下单
- 充值 / 提现:金额溢出,负数提现变成给账户加钱
- 积分 / 优惠券:数量溢出,无限刷积分、刷券
- 库存系统:库存溢出,负数库存超卖
实战测试:
以后碰到任何和「数值计算」挂钩的参数(数量、金额、积分、次数、余额),除了测正常值、负数、0,必须补测极大值边界:
- 一直堆数量 / 金额,观察会不会出现异常值、负数、系统崩溃
- 重点关注老系统、C/Java 编写的后端、用 int 存金额的系统
修复:
- 金额、积分这类敏感数值,绝对不能用普通
int存储,要用long(长整型)或高精度十进制类型(如 Java 的 BigDecimal)。 - 所有数值计算前后,必须做边界合理性校验:结果为负、超出合理范围,直接拒绝操作。
- 结算环节做二次校验:总价必须大于 0、小于合理阈值,异常订单直接拦截。
场景:特殊输入处理不一致(字符串截断漏洞)
这是业务逻辑漏洞里非常经典的「多组件处理标准不一致」类型,核心成因是:同一个输入数据,在业务流程的不同环节,长度限制、处理逻辑不一样,最终导致数据的 “实际存储值” 和 “业务校验值” 出现偏差。
本题漏洞原理:
| 业务环节 | 处理逻辑 | 长度限制 | 最终结果 |
|---|---|---|---|
| 邮件发送环节 | 完整读取整个邮箱字符串,按完整域名投递邮件 | 无截断 | 邮件会发送到完整地址对应的收件箱 |
| 数据库存储环节 | 用 varchar(255) 字段存储邮箱,超过 255 个字符的部分自动截断丢弃 |
最多存 255 字符 | 用户表中最终保存的邮箱,只有前 255 位 |
| 管理员权限校验 | 读取数据库里存储的邮箱,判断后缀是不是 @dontwannacry.com |
按截断后的存储值判断 | 只要截断后后缀是公司域名,就判定为内部员工,开放管理权限 |
发邮件的时候,这个邮箱是你的;存进数据库后,这个邮箱就变成公司的了。两个环节处理标准不一致,我们就能造出一个「能自己收邮件、系统认为是公司员工」的管理员账号
经实验可发现邮箱名被截断
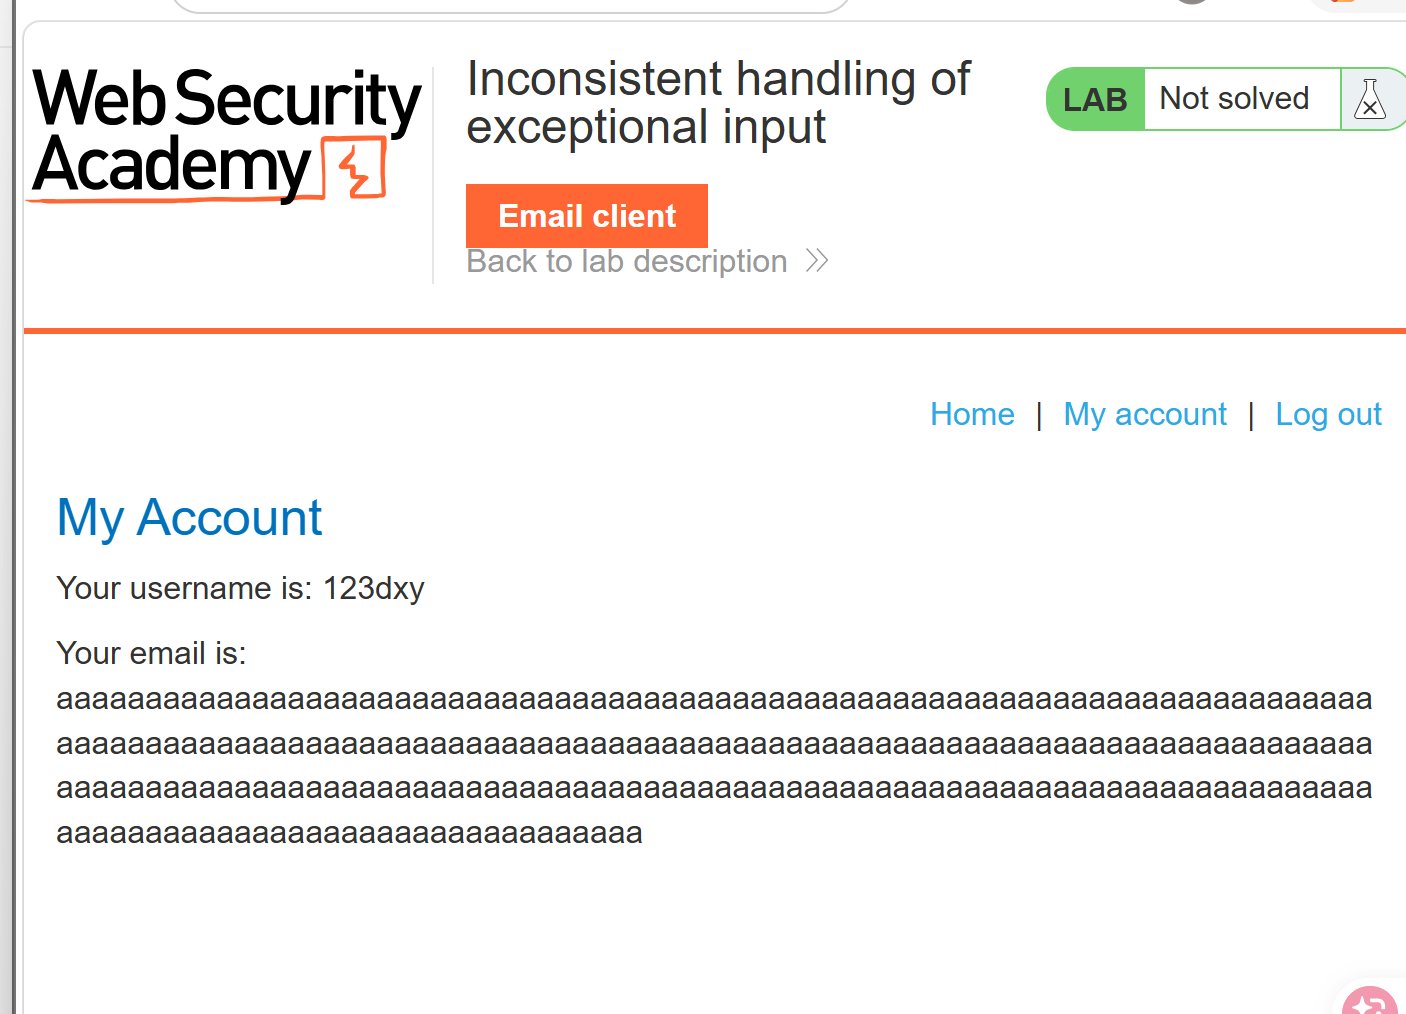
拼接出
1 | aaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaa@dontwannacry.com.exploit-0ac700bd039c4fd280a3de2501c80022.exploit-server.net |
重新注册,成功卡上截断
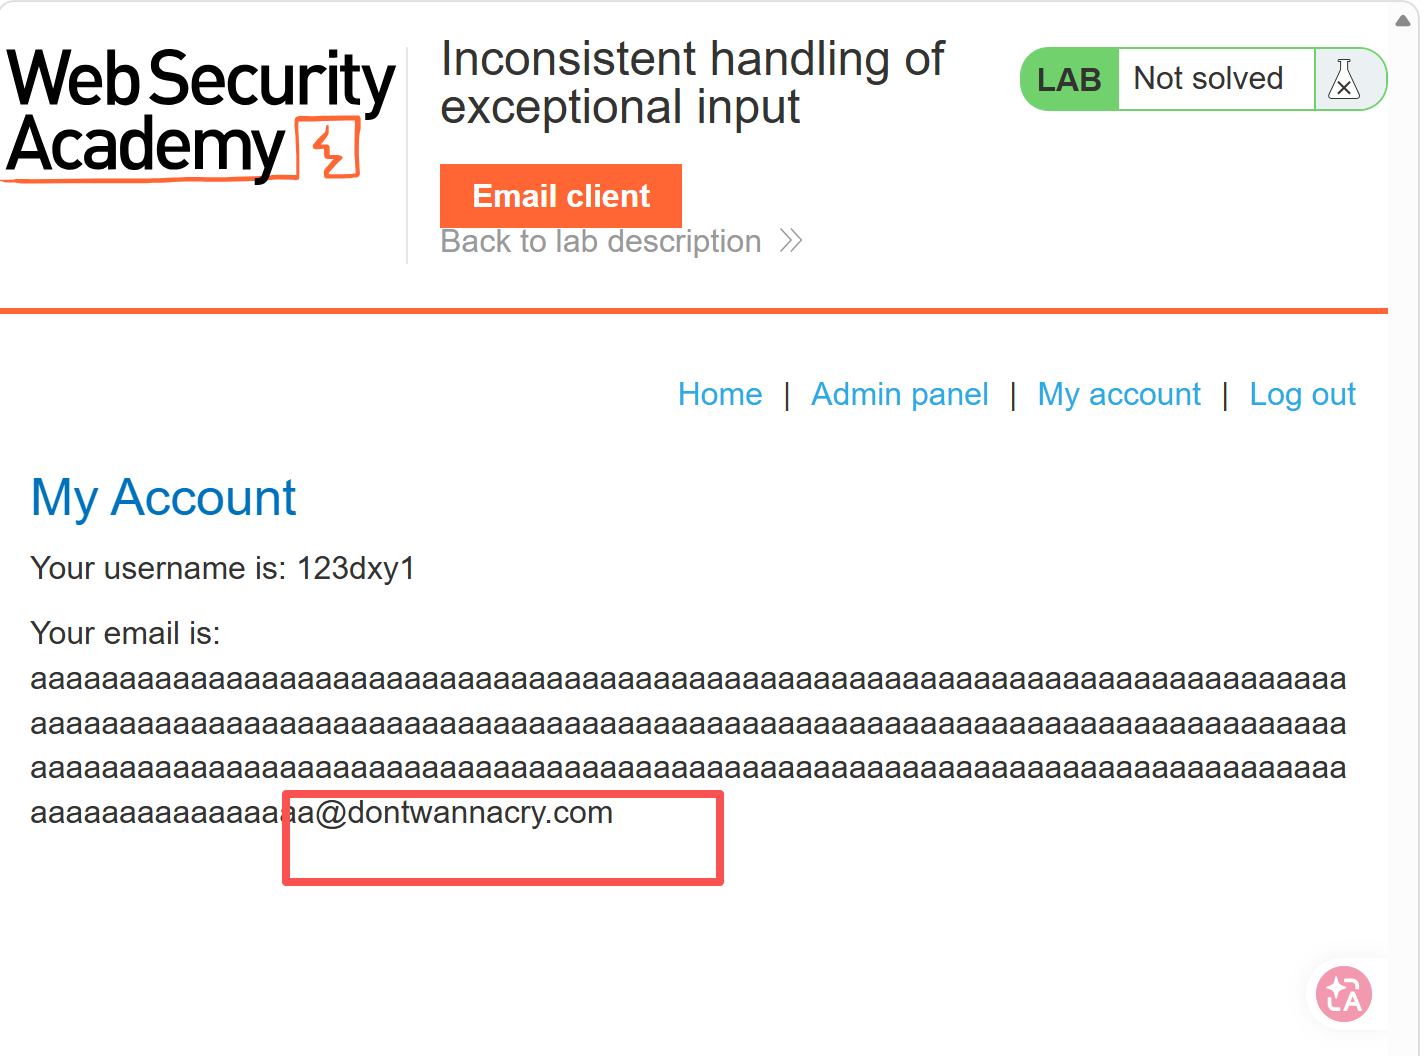
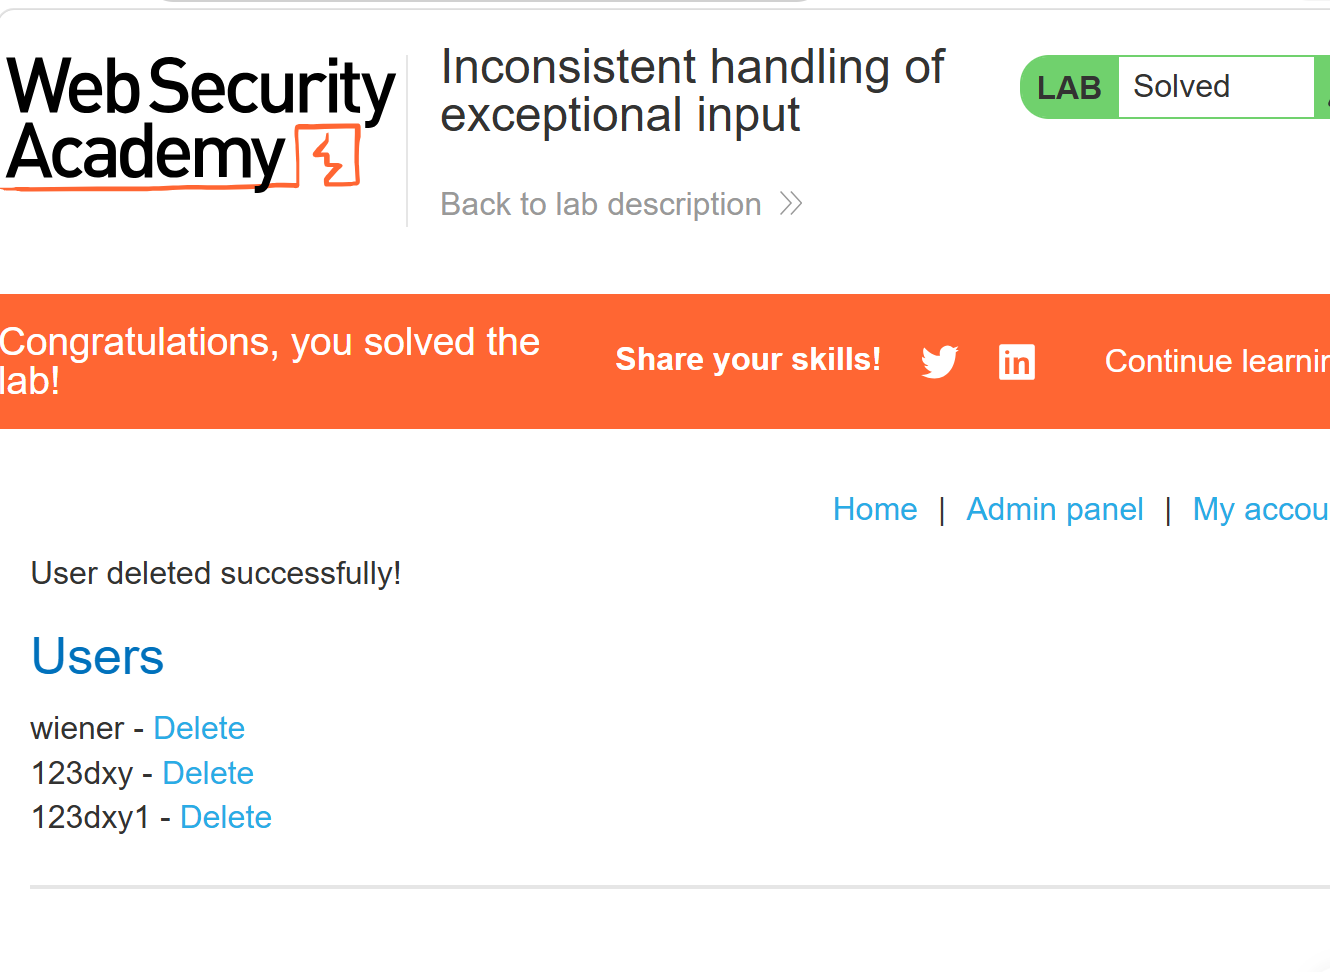
此时被系统认为是管理员,再进去就能进入/admin了
这里有一个值得注意的细节是,我们注册账户的时候,系统发邮件使用的是完整的地址,但是与此同时,存入数据库的时候,被截断了,因此后续进入admin路径时校验的也是这个错误的值。
问题出现的原因:
- 数据库层:默认静默截断 数据库字段设为
varchar(255),且开启了宽松写入模式 —— 超过长度的字符不会报错,直接静默丢弃,只存前 255 位。应用层感知不到数据被改了。 - 应用层:输入长度校验完全缺失 注册接口没有对邮箱长度做限制,允许超长字符串提交。正常的设计应该是:==注册时就限制邮箱长度≤255,超长直接返回 “邮箱长度非法”,根本到不了数据库截断这一步。==
- 业务层:多环节处理标准不统一 发验证邮件用「原始完整邮箱」,存数据库用「截断后邮箱」,权限校验又直接读「截断后的数据库值」。三个环节各用各的,没有统一校验,最终导致 “验证的是一个邮箱,认权限的是另一个邮箱”。
字段长度本身不是问题,问题是 “长度限制只在数据库层静默生效,业务层完全没感知、没对齐”。
实战排查:
==思路:同一个输入,分别看「提交值、页面显示值、数据库存储值、业务逻辑使用值」是不是同一个。只要出现不一致,就存在截断类漏洞。==
==高价值字段,测试长度,有问题看多个场景使用的是多长的截断,测试精准卡点,有没有可利用的场景==
具体排查步骤
定位高价值字段
优先测所有和
身份、权限、计费、安全校验
挂钩的字段:
- 账号类:邮箱、用户名、手机号、昵称
- 权限类:角色标识、部门 ID、商户类型
- 文件类:文件名、后缀名
- 其他:地址、备注、邀请码
超长输入初测
构造一个远长于常规长度的字符串(比如 300 位、1000 位的纯字母),提交到对应接口。
- 如果直接报错 “长度超限”:说明应用层做了校验,基本没有截断风险;
- 如果提交成功,没有报错:大概率存在数据库静默截断,继续深入测。
多环节结果比对(关键)
提交超长值后,分别在不同场景看这个字段的实际值:
- 页面回显的值是多长?
- 个人中心 / 资料页显示的值是多长?
- 触发业务功能时用的值是多长?(比如发邮件、权限校验、充值结算)
- 只要出现「提交的很长,但显示 / 使用的变短了」,就实锤了截断漏洞。
精准卡边界,判断可利用性
用经典长度边界值精准测试,找到截断点:
- 常见截断长度:255、512、1024、4096、65535
- 比如邮箱场景,就精准构造到 255 位,看截断后的后缀能不能用来绕过权限、伪造身份。
快速定位技巧:
- 看到
varchar(255)级别的长度,优先测邮箱、用户名这类身份字段; - 看到系统用「邮箱后缀、用户名后缀」判断权限 / 身份,直接构造超长字符串测截断;
- ==老系统、PHP+MySQL、Java+MySQL 架构,静默截断的概率极高。==
修复方案:
应用层前置长度校验、数据库开启严格模式,业务层全链路统一标准、多重校验
1. 应用层:前置长度校验(最优先)
所有用户输入,在进入数据库之前,就在接口层做长度校验:
- 邮箱限制长度≤254(国际标准邮箱最大长度),超长直接返回参数错误;
- 用户名、昵称等按业务需求设上限,超限直接拒绝。
核心原则:永远不要依赖数据库做输入校验,所有合法性校验必须在应用层完成。
2. 数据库层:开启严格模式,禁止静默截断
- MySQL 关闭宽松模式,开启
STRICT_TRANS_TABLES严格模式; - 超过字段长度的数据,直接返回报错,不自动截断、不静默写入。
让问题暴露在写入前,而不是偷偷改数据。
3. 业务层:全链路标准统一 + 多重校验
- 所有环节使用同一套长度规则:注册、修改、存储、权限校验,长度限制完全一致;
- 关键权限判断,绝对不能只依赖「可被截断的单一字段」。比如员工权限不能只看邮箱后缀,必须配合员工表、角色 ID、工号等多重校验;
- 敏感操作二次校验:进入管理后台、支付结算这类关键操作,重新校验完整身份信息,不直接复用资料里的字段值。
场景:双用途终端设备的隔离措施不完善(账号管理类垂直越权漏洞)
这个漏洞的场景原型是:很多系统的「用户自助改密」和「管理员改密」共用了同一个后端接口,本应做权限隔离 —— 普通用户只能改自己的,管理员才能改他人密码。 但这里完全没做隔离,普通用户登录后,只需修改请求里的username参数,就能直接修改管理员密码,实现普通用户→管理员的垂直越权。
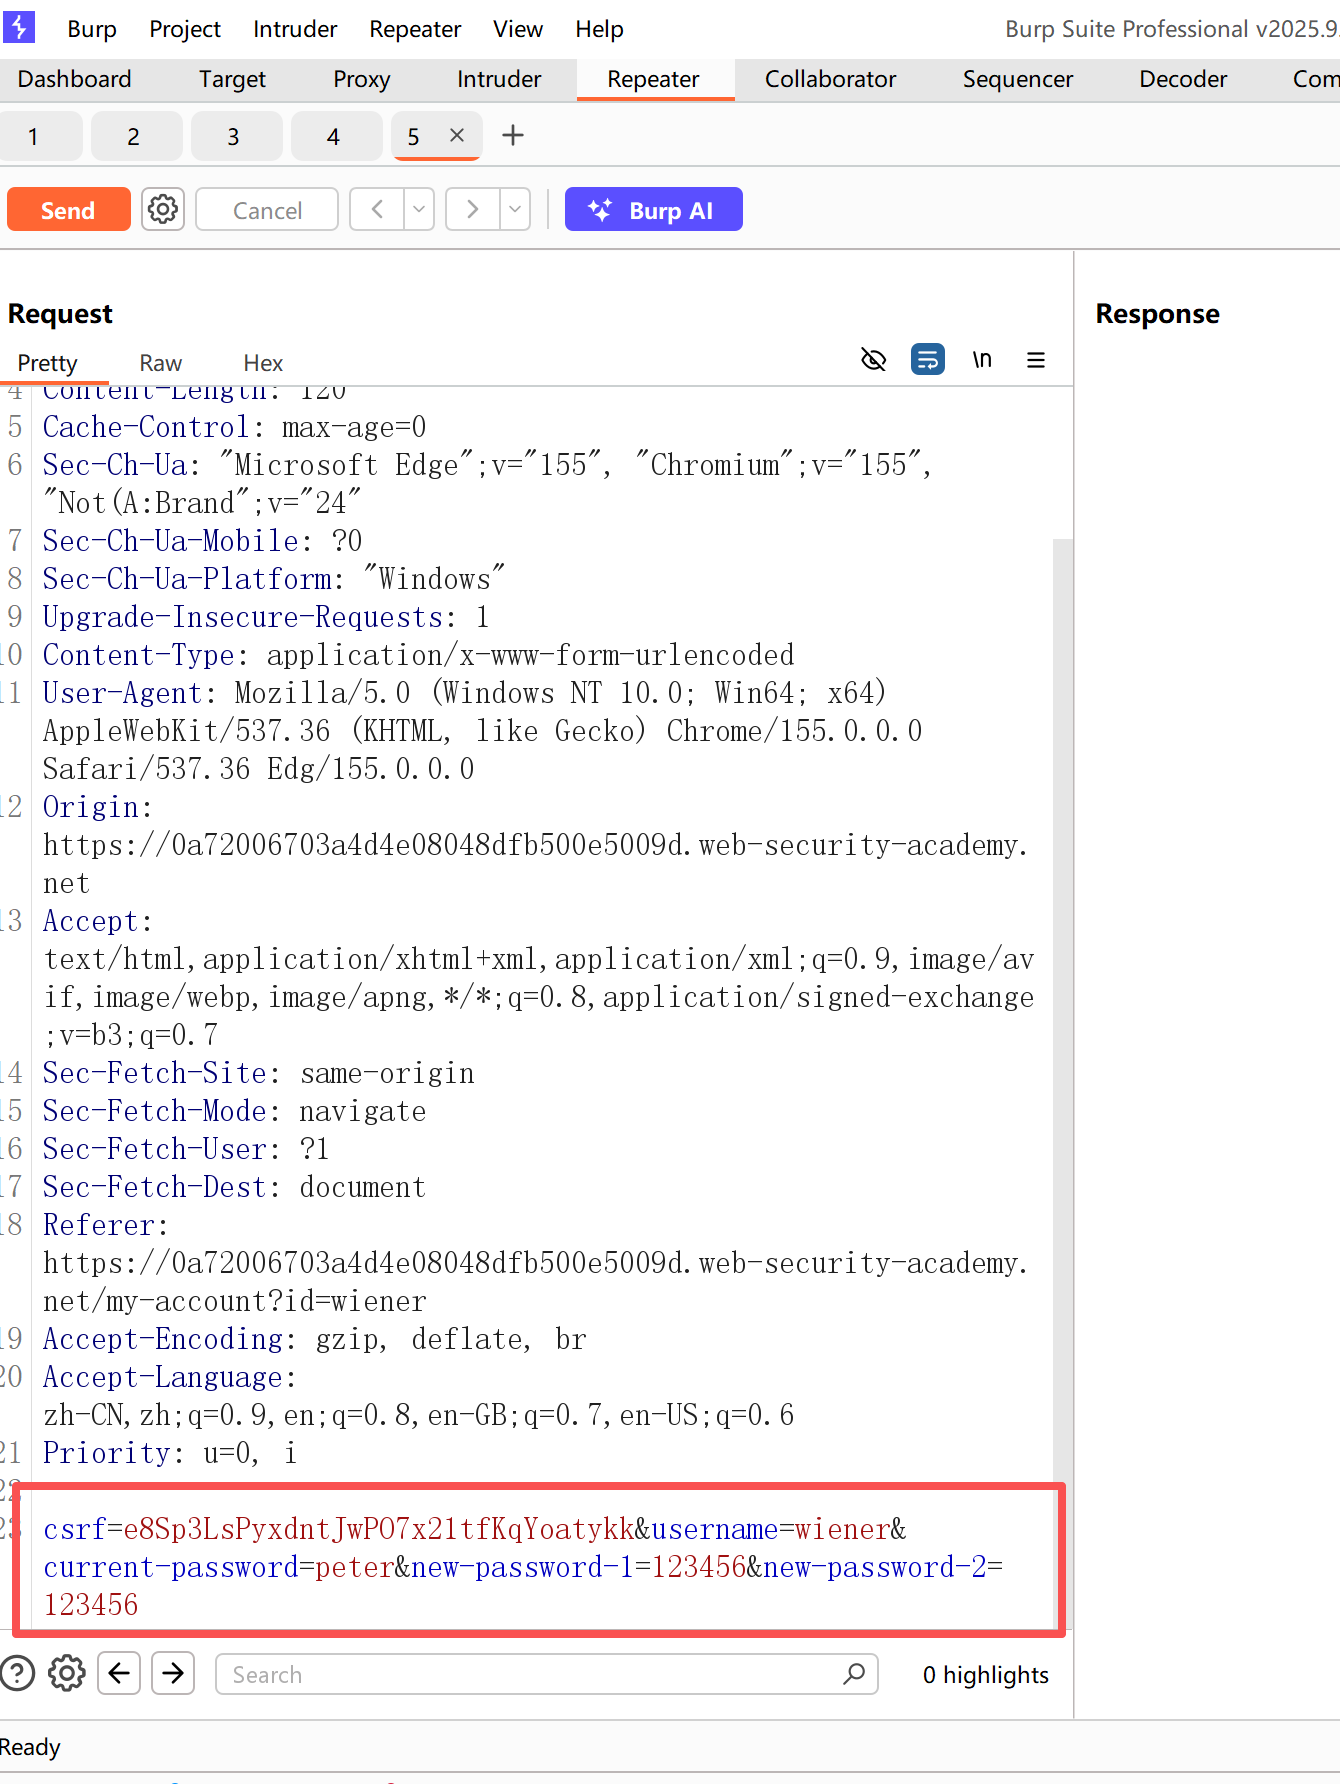
可以看到这里传参旧密码、用户名、两次新密码
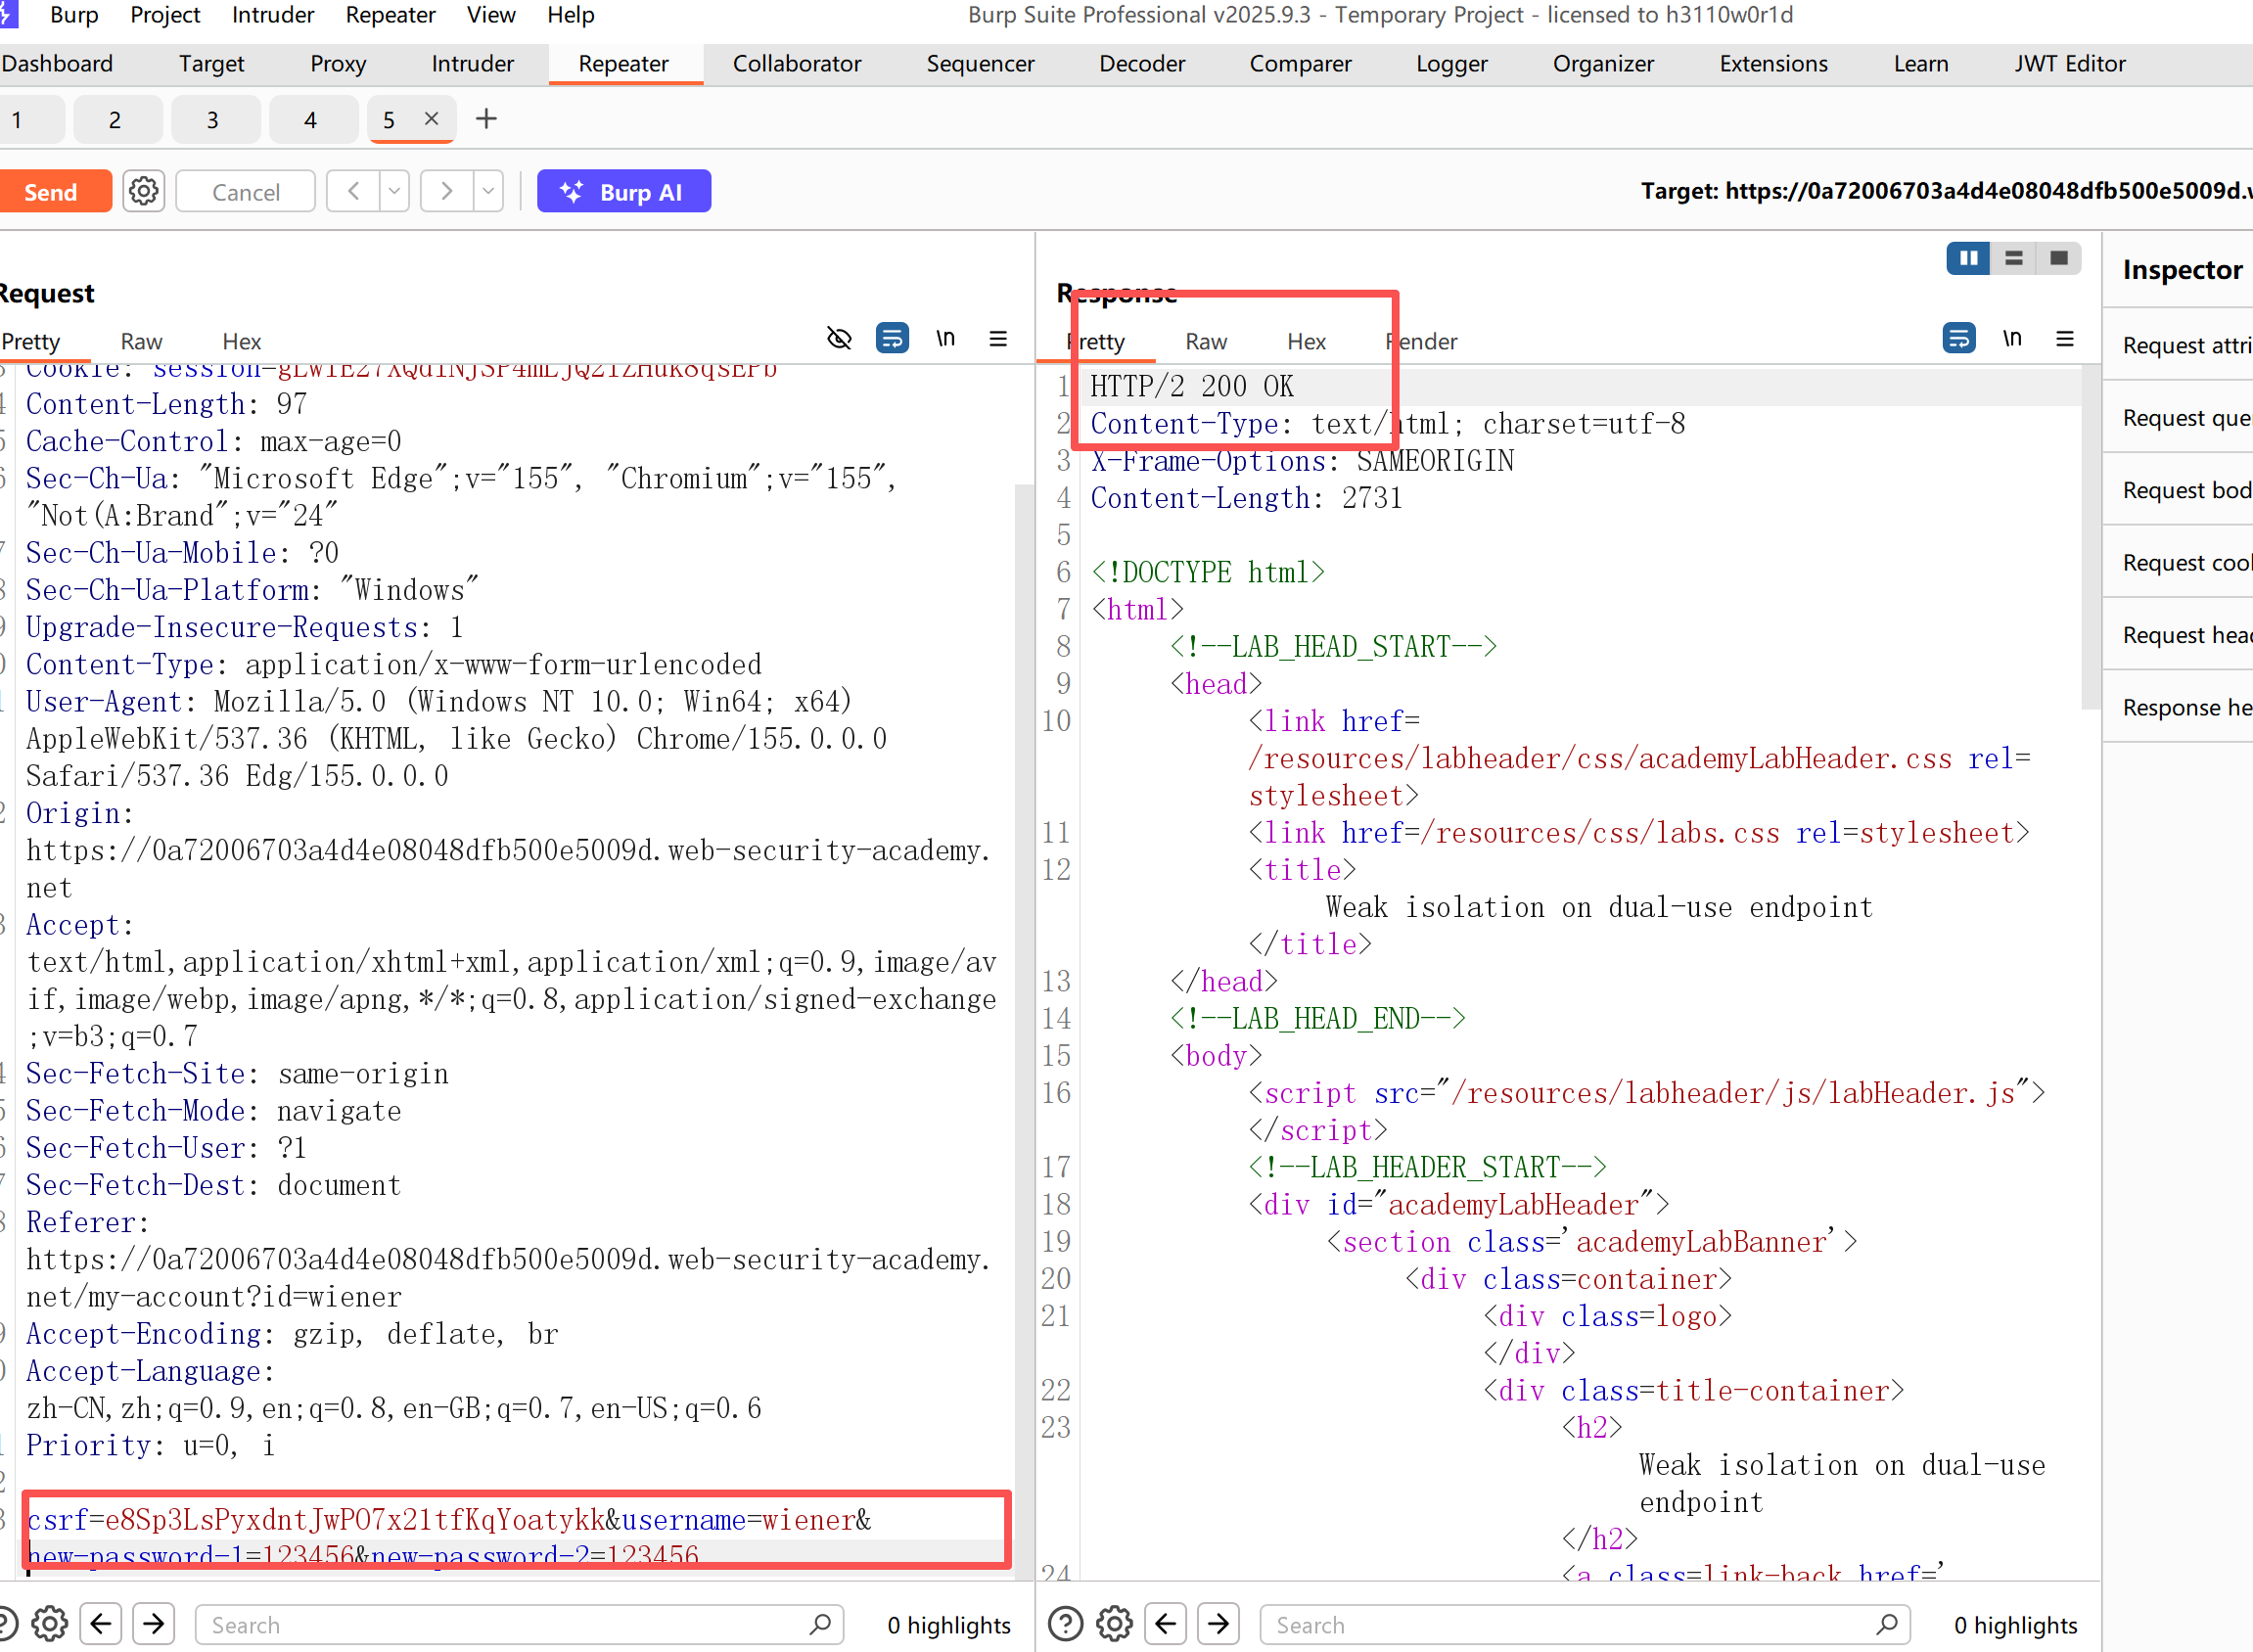
实测发现不用原密码也可以更改密码
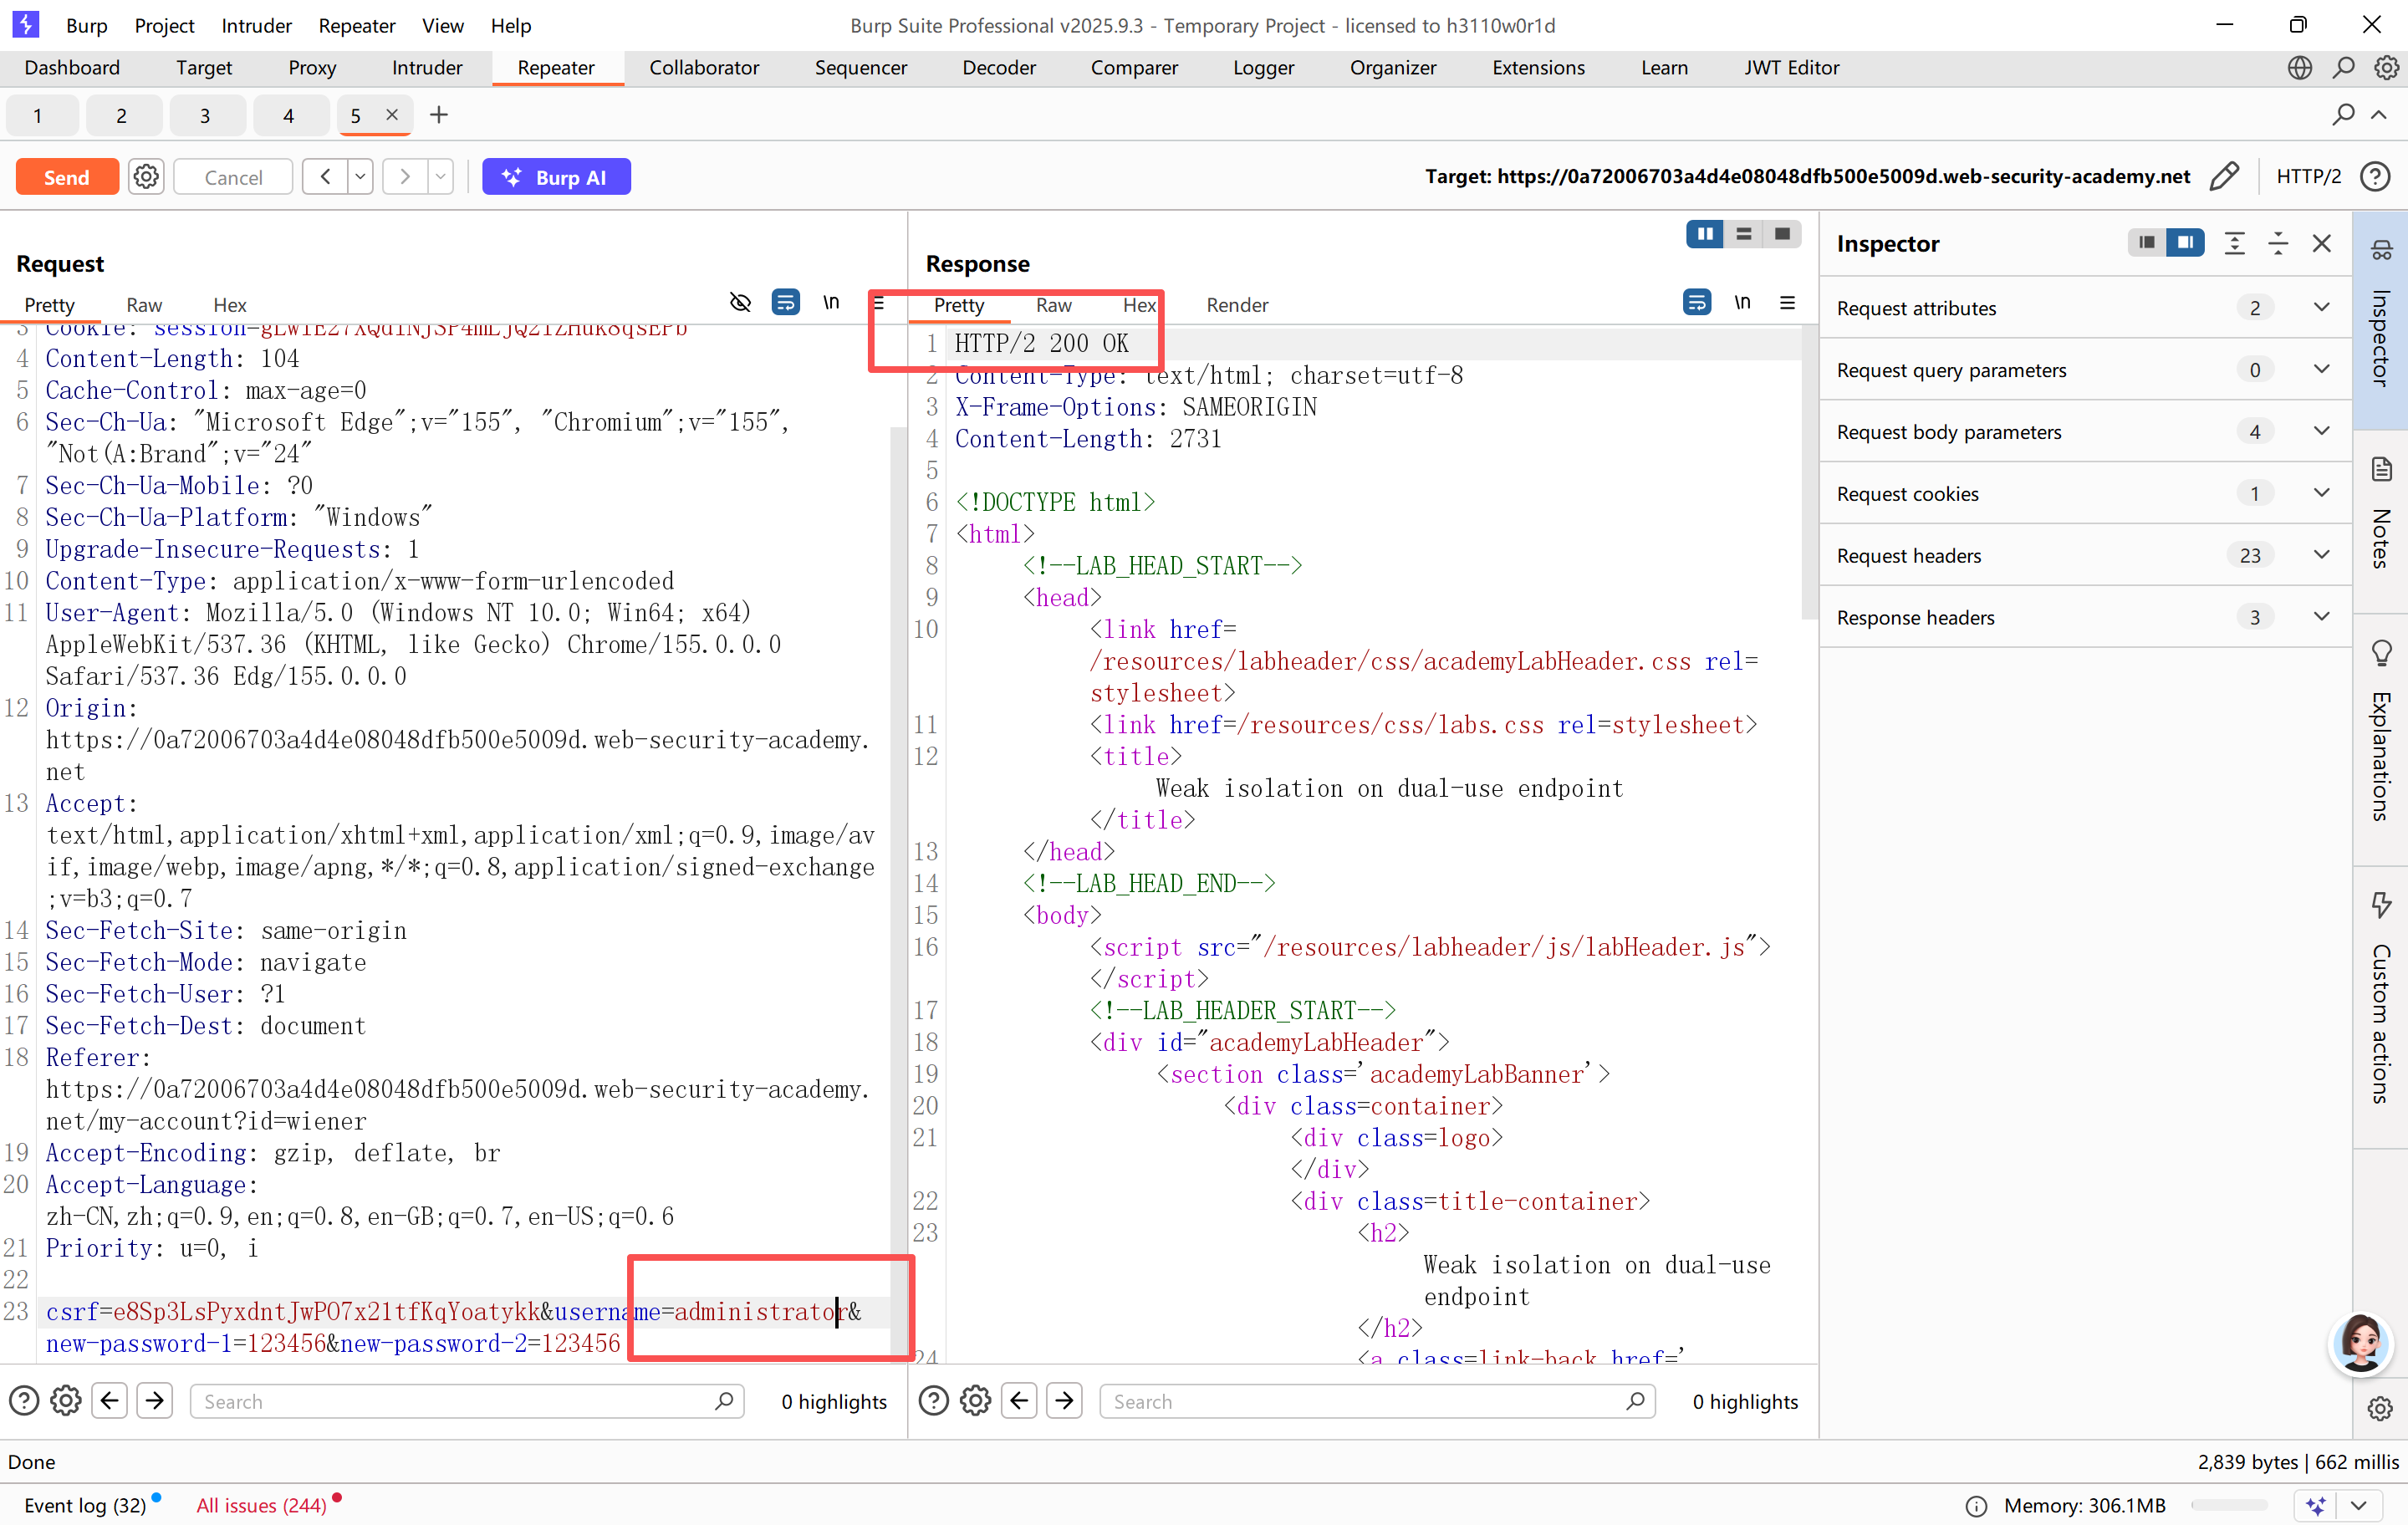
再一步实测发现用户名也可以更改,直接越权改别人的密码。
所有账号管理类功能都可能出现同类问题:修改密码、重置密码、修改个人信息、绑定手机号、注销账号、查询订单…… 只要目标用户的标识(ID / 用户名 / 手机号)是客户端可控制的参数,就大概率存在越权。
标准测试流程:
碰到任何用户信息修改接口,固定做两个测试:
- 删掉鉴权参数(原密码、验证码、token),看能不能成功执行;
- 修改用户标识参数为其他用户的,看能不能操作他人账号。
修复方案
- 目标用户从会话取:修改密码、修改资料的目标用户,必须从当前登录的 session 中获取,绝对不接受客户端传入的用户标识。
- 敏感操作二次校验:改密、注销、绑定等高危操作,必须验证原密码 / 短信 / 邮箱验证码。
- 权限严格隔离:普通用户和管理员的操作接口分离,普通用户接口禁止操作管理员账号。
场景:工作流程验证不足(流程顺序绕过)
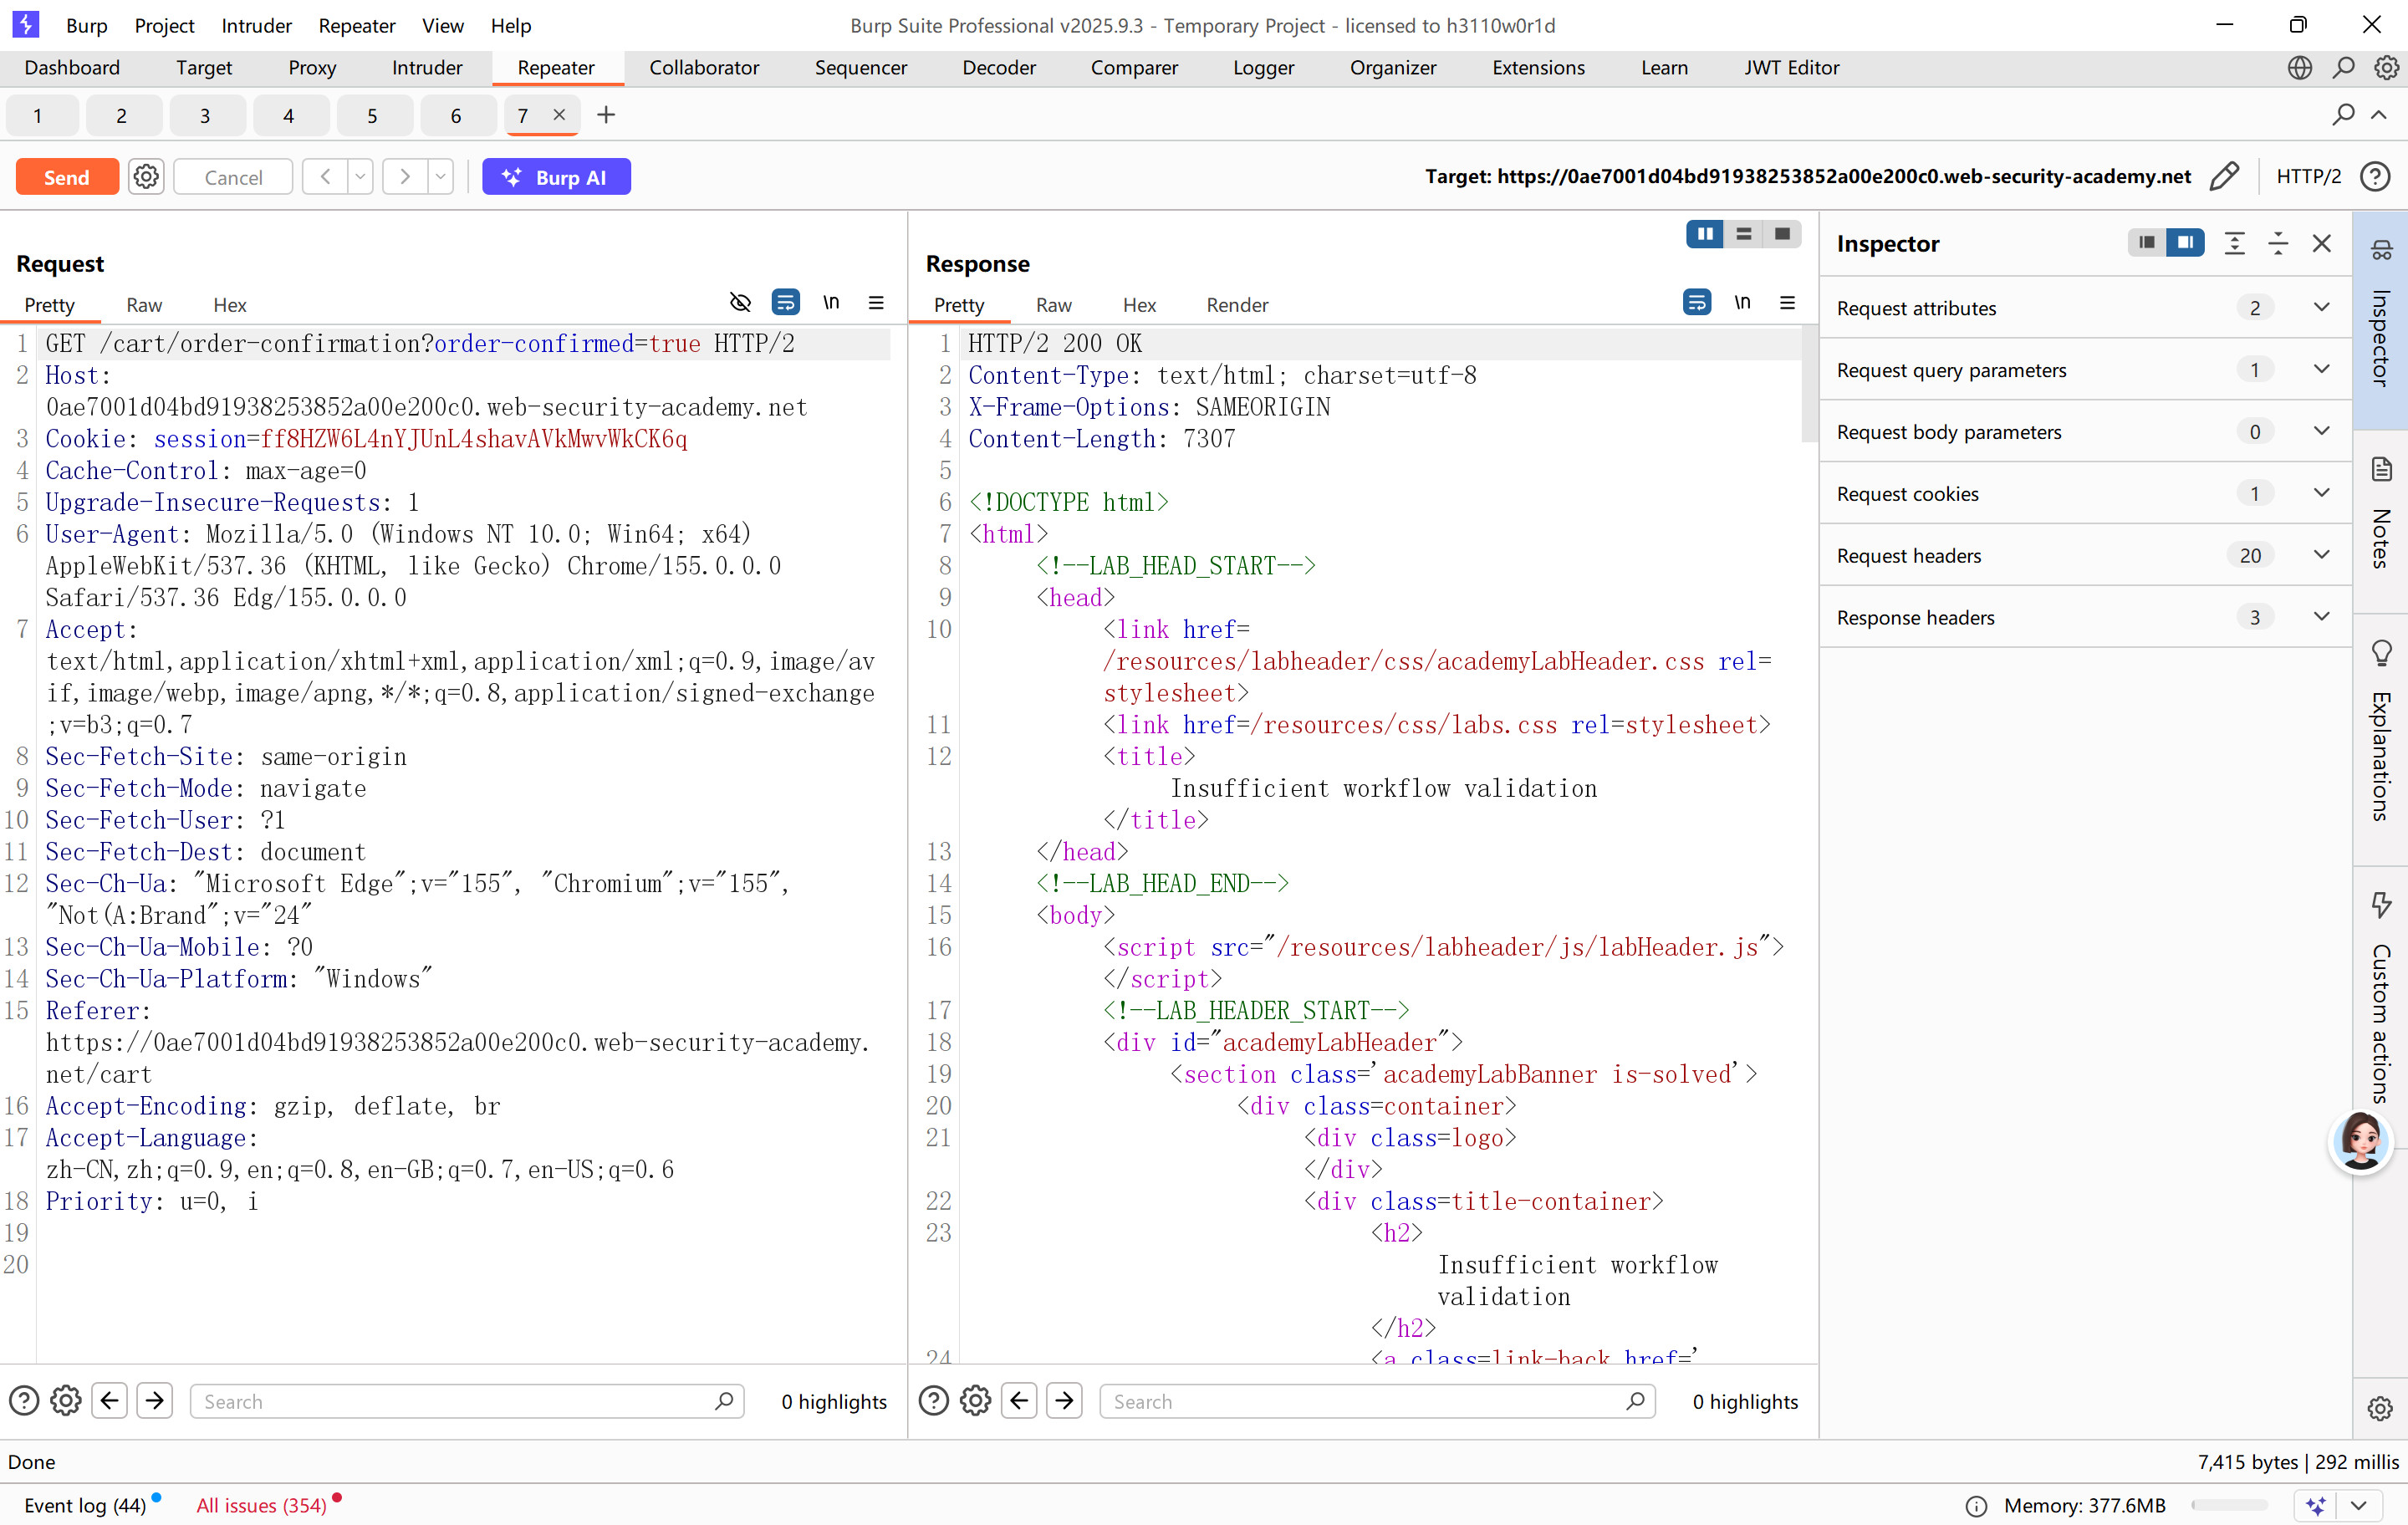
拦截订单创建完返回的这一步。重放即可。这里的问题其实还是类似之前访问控制里面的,默认假设用户一定会按照流程走,在前面的流程做了校验,后面不做。直接跳过中间步骤到后面就可以绕过。
常见场景:
- 支付场景:跳过支付网关,直接访问支付成功回调接口,订单直接变成已支付
- 注册场景:跳过手机 / 邮箱验证步骤,直接访问注册成功接口,完成账号注册
- 抽奖 / 签到:跳过消耗积分 / 每日限制的步骤,直接调用抽奖 / 签到接口,无限领取奖励
- 问卷 / 活动:跳过答题 / 浏览步骤,直接提交完成,领取活动奖励
测试步骤:
实战中有很多业务逻辑都是多步骤的,但不是每一个都值得慢慢逐步测试。有以下业务值得优先测试流程绕过。
==支付、奖励、认证、审批等可以先看。和钱、积分、奖励、权限挂钩的多步骤流程,优先拆。纯信息展示类的流程,没必要浪费时间。==
| 优先级 | 场景 | 核心危害 | 命中率 |
|---|---|---|---|
| 第一梯队 | 支付 / 订单确认、充值回调、续费开通 | 零元购买、绕过支付 | 极高 |
| 第一梯队 | 新人奖励、签到领奖、活动抽奖、任务兑换 | 无限刷积分、优惠券、奖品 | 极高 |
| 第二梯队 | 注册激活、邮箱 / 手机验证、实名认证 | 绕过验证直接完成注册 / 认证 | 中高 |
| 第二梯队 | 问卷提交、答题领奖、浏览任务 | 跳过答题 / 浏览直接领奖励 | 中 |
| 第三梯队 | 审批流程、工单流转、多级审核 | 跳过下级直接终审通过 | 中低 |
有以下标准测试步骤:
==正常按照页面引导,走完整个业务流;==
==从最后一步开始倒着测试;==
==区分展示页和执行页;==
==验证影响范围==
第 1 步:走通一次完整流程,抓全所有包
正常按页面引导,从头到尾走完一遍完整业务,让 Burp 记录下所有请求。
- 重点标记:每一步的接口、跳转关系、每个步骤传的参数。
- 不用着急改,先把完整链路理清楚:步骤 1→步骤 2→步骤 3→最终结果。
第 2 步:从最后一步开始,往前跳着测(核心技巧)
不要从第二步开始试,直接从最后一步的结果接口开始测:
- 清空当前业务状态(比如清空购物车、重置任务);
- 只完成第一步(比如加购、报名),中间步骤完全不做;
- 直接重放最后一步的「结果执行接口」,看能不能直接触发最终状态。
为什么从最后一步开始? 开发的校验逻辑,通常都是「前紧后松」:入口、结算步骤校验最严,越到后面的确认、完成步骤,越容易默认「前面都校验过了」,直接放行。 直接跳最后一步,能成就是血赚;不成,再往前跳一步试,效率最高。
第 3 步:区分「展示页」和「执行接口」(新手最容易踩的坑)
不是所有 “最后一页” 都有用,必须分清楚:
- ❌ 纯展示页:只是读取订单状态给你看,状态已经在前面的步骤改好了。你跳过去也只是看到个页面,业务状态没变化,等于白跳。
- ✅ 执行接口:访问这个接口,会真的修改业务状态(比如把订单改成已支付、把奖励发到账户、把账号设为已验证)。
判断方法: 访问前先看一下当前业务状态(比如订单是待支付、积分没增加),重放请求后再刷新看状态变没变。
- 状态变了:是执行接口,漏洞实锤;
- 状态没变,只是页面显示成功:纯展示页,没用,继续往前找真正的执行接口。
第 4 步:验证通用性
确认能跳过之后,再试一下能不能跳过更多步骤、能不能用其他身份触发,确认危害等级。
高概率信号:
==步骤之间没有凭证传递、==
==最后一步的参数简单、==
==报错泄露下一层接口、==
==浏览器能乱序访问业务流程。==
- 步骤间只有页面跳转,没有凭证传递 每一步之间,没有 step_token、流程号、校验码这类参数,只是单纯的页面跳转。说明服务端完全没做流程进度校验,只靠用户按顺序点。
- 最后一步的参数极其简单 比如订单确认接口只有
order_id=xxx,没有支付签名、没有校验 token。说明它默认只要能访问这个接口,就是付过款的。 - 报错信息泄露下一步地址 比如支付失败页面、未完成页面,直接提示「支付成功后将跳转到 xxx」,等于直接把后面的接口地址告诉你了。
- 浏览器前进后退能乱序访问 做完第一步,直接在地址栏改路径进第三步,页面能正常打开,不强制跳回第一步。基本就说明流程没有强校验。
修复方案:
- 状态独立校验:订单确认接口必须先查询对应订单的支付状态,已支付才能确认,未支付直接拒绝。不能默认 “访问确认页就是付过款了”。
- 流程凭证绑定:每一步生成唯一的流程 token,必须携带上一步返回的有效 token,才能访问下一步接口。
- 关键状态服务端落库:扣款成功才会把订单标记为「已支付」,确认页只负责展示状态,不能修改订单状态。
变种:
正序颠倒和重复执行。
- 顺序颠倒 正常是「完成任务→领取奖励」,但可以先领奖励,再去做任务。 测试方法:先直接调用领奖接口,看能不能到账。
- 重复执行 正常是「一次任务→一次奖励」,但结果接口没有做次数校验,可以无限重放最后一步,无限领奖励。 测试方法:同一个确认 / 领奖请求,重发多次,看奖励是不是叠加。
场景:多步认证流程(有缺陷的认证状态机)
这是多步认证流程里的经典逻辑漏洞,本质是「身份认证和权限分配分离,状态机步骤之间没有强绑定校验」。
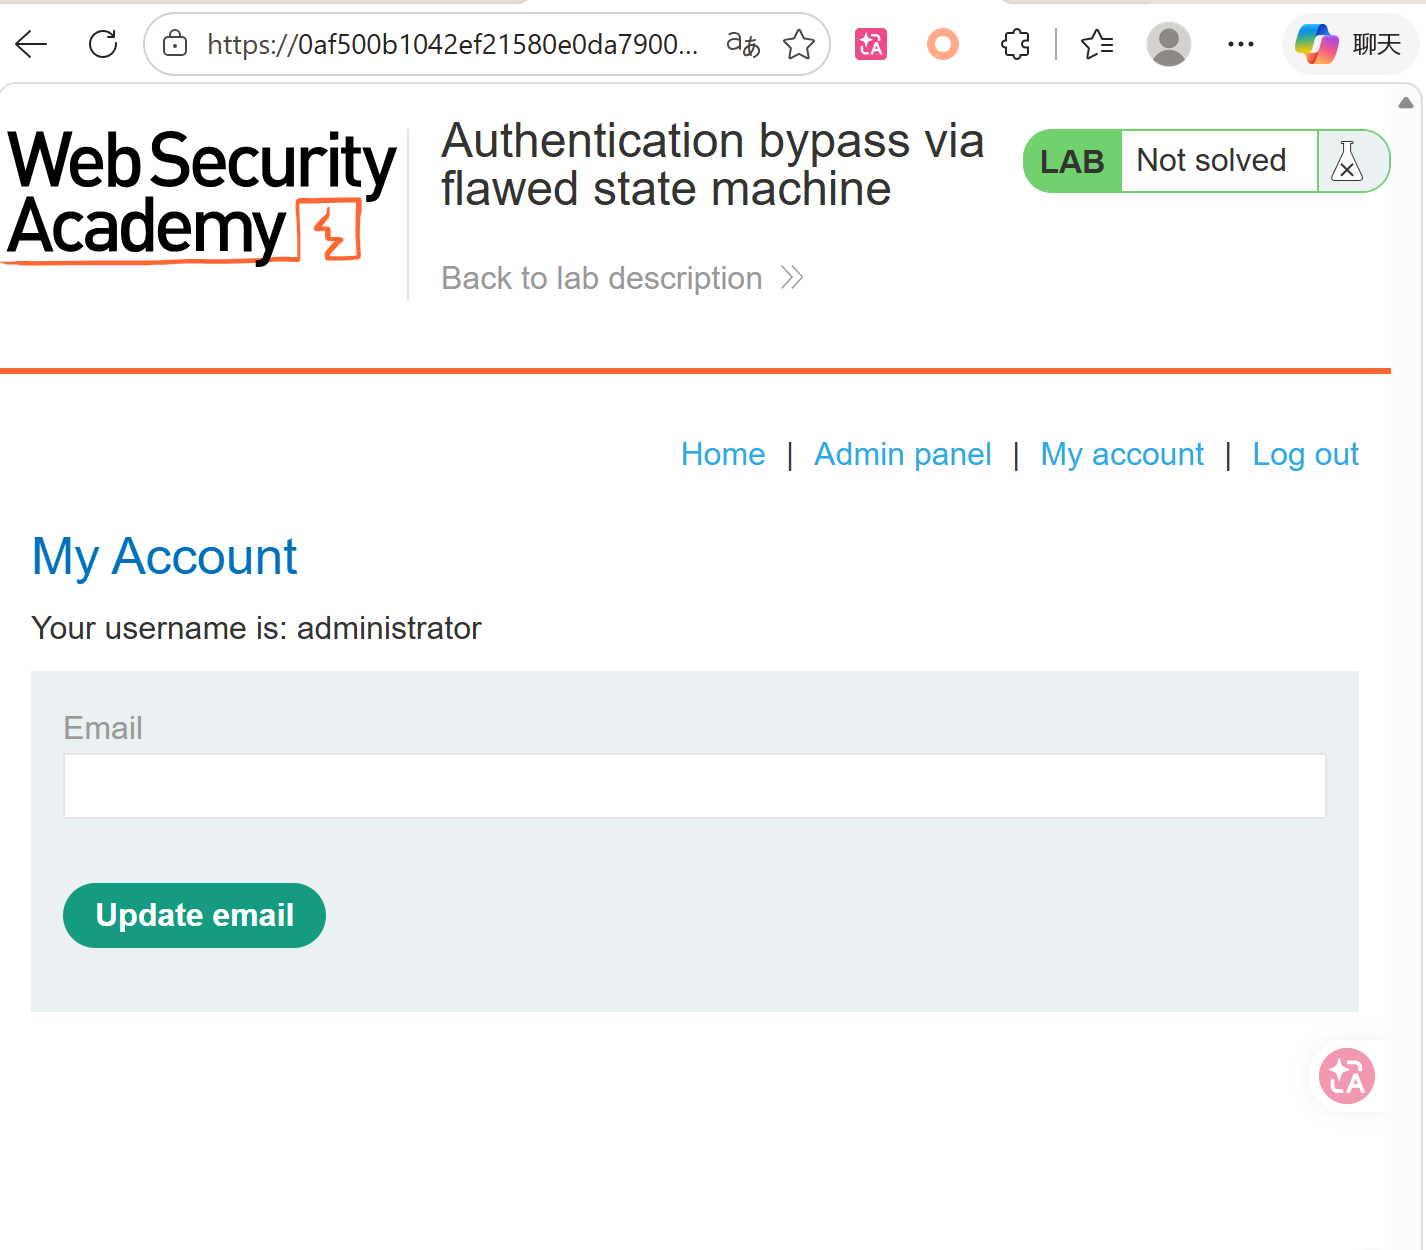
这道题其实有点为了出题而出题的感觉,做下来有点无厘头,是一开始是admin,后面的步骤中由用户自己降级,然后这个过程中跳步保留admin状态。

bp开着代理跑了一遍全程。登录,get角色选择,跳转回去,post角色选择。
一开始我确实忽略了get这条,看见post里面有参数,就以为post这条才是角色状态转换的执行点。尝试了很多次都不对劲。
然后后来注意到cookie的变动,从get这里开始忽略掉,直接回去进/admin才正确找到入口。
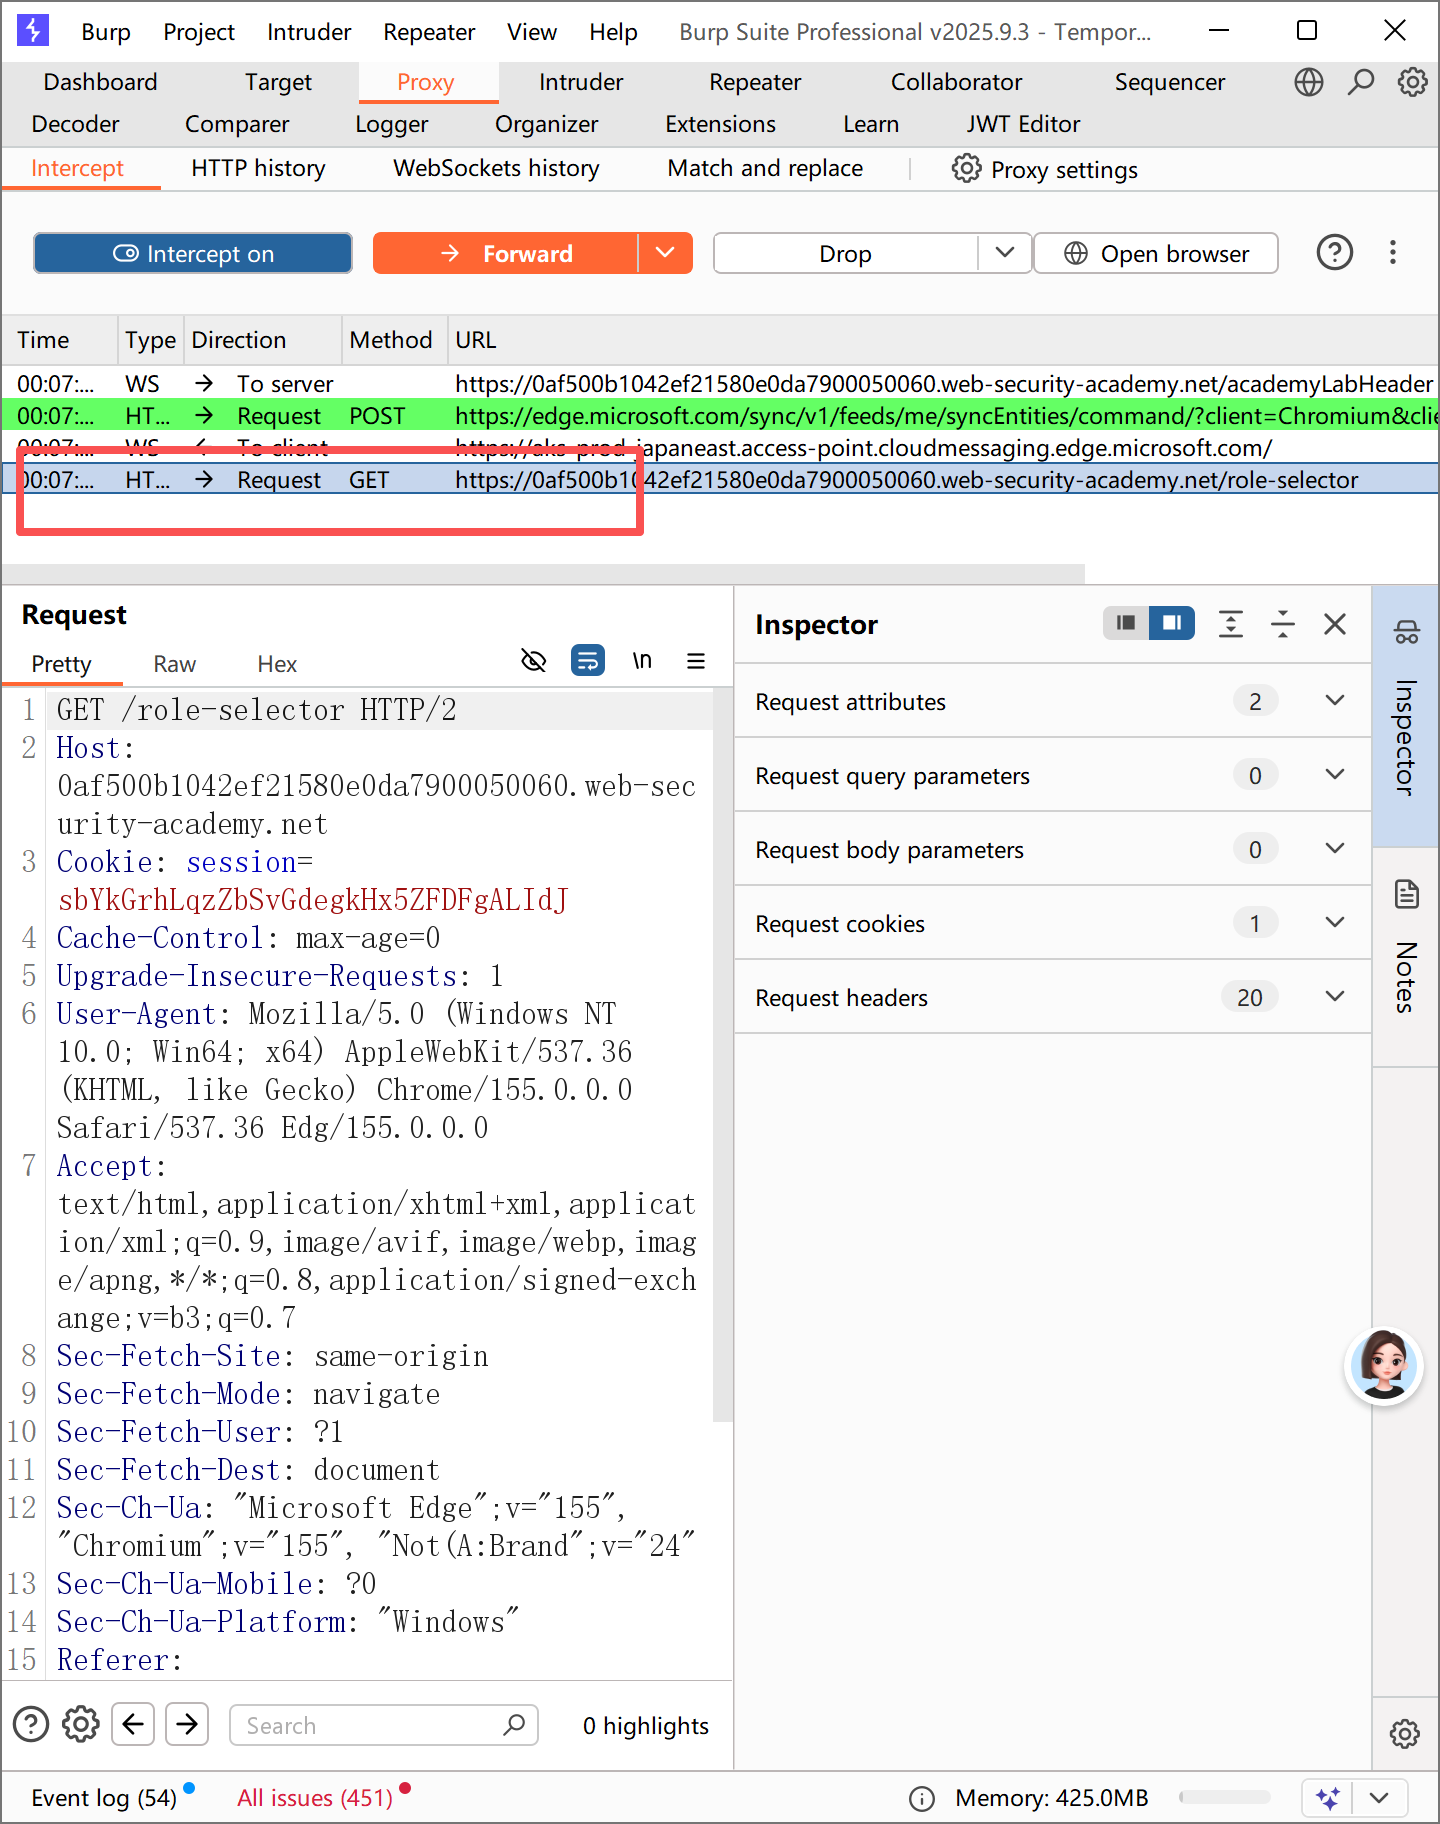
这道题的状态变化是这样的:
| 请求 | 服务端状态 | 结果 |
|---|---|---|
POST /login |
创建会话 S1,默认 role=administrator | 302 到 /role-selector,浏览器保存 S1 |
GET /role-selector |
进入角色选择状态,角色不再是默认 admin,换会话 S2 | 返回选择页面 |
POST /role-selector role=user |
记录选的角色,换会话 S3 | 302 到 /my-account,你变成普通用户 |
| 在 Burp 里 drop 掉 GET | 不进入角色选择状态,S1 保留 | 手动访问 /my-account 或 /admin 时仍是 admin |
登录后,浏览器会自动跟随 POST /login 的 302 去请求 GET /role-selector。这条 GET 到达服务器后,服务端会把会话从“刚登录、默认 administrator”推进到“角色选择中”的状态,并换一个新的 session。截图里的 Cookie 列其实已经显示了这个变化:m1dR6y... → 1J7DV4... → h9v6Kfxx...。
因此直接在浏览器里登录之后,在地址栏敲 /admin 时,浏览器带的是 GET 之后的新会话,角色已经不是默认的管理员了,所以被拒绝。
==也就是说,“不管角色选择这个东西”在浏览器层面做不到:页面还没显示出来,GET 已经把状态改了。==要做的是在代理层让这条 GET 根本不到达服务器,这样浏览器手里保留的还是登录响应给的那个 session,服务端也还停留在默认 administrator 状态。
实战怎么判断这种状态切换:
同一个接口,换不同步骤的 cookie 去请求的对比,是判断状态机漏洞最可靠的方法。不要靠猜哪条请求“看起来像执行点”。
- 打开 Intercept,并在 Repeater 或 Proxy 里关掉 Follow redirects。否则浏览器会自动把 302 后面的 GET 跟掉,你根本看不到它。
- 登录,放行
POST /login。看到 302 时先别急着放行下一条,把响应里的Set-Cookie记作 S1。 - 用 S1 直接在 Repeater 里请求
/admin(或这条流程最终要保护的接口)。如果这时候能进,说明登录后的默认状态就有权限。 - 再放行
GET /role-selector,观察它的响应有没有Set-Cookie或Location。如果有新 cookie(S2),用 S2 再请求一次/admin。如果 S1 能进、S2 不能进,那这条 GET 就是状态转换点。 - 反过来验证:重来一次,直接把
GET /role-selectordrop 掉,然后用 S1 访问/my-account或/admin。如果能进,就可以确认问题就在这条 GET 上。
| 步骤 | 请求 | 发出的 cookie | 响应 Set-Cookie | 访问 /admin 的结果 |
|---|---|---|---|---|
| 1 | POST /login |
S0 | S1 | 200 |
| 2 | GET /role-selector |
S1 | S2 | 403 |
| 3 | POST /role-selector |
S2 | S3 | 403 |
很明显第二步就丢了权限。
场景:无限金钱机制中的逻辑漏洞
这道题的漏洞大概如下:
有三美金面额的折扣卡,并且可以无限使用。但是这里有个问题,这张折扣卡并不禁止用在礼品卡上面。那么就可以无限制地通过用这个折扣买礼品卡兑现,不断薅三美金羊毛。


补充:
这部分还没来得及整理
怎么在src规则范围内进行高效信息搜索
先把底线划死,这些绝对不能碰,碰了就算违规骚扰:
- 范围红线:只测厂商对外公开的官网、业务系统;企业内网、OA、员工系统、内部后台、第三方合作平台,一律不能碰。
- 行为红线
- 禁止全量漏洞扫描器(AWVS、AppScan 全开扫描)、批量 SQL 注入跑库、账号暴力破解、短信轰炸
- 禁止高并发压测,不能把网站扫出 5xx、卡顿、限流
- 禁止拖库、批量遍历用户数据、下载敏感文件
- 禁止扫描内网、以拿到的权限为跳板扩范围
- 核心判断标准:你的操作会不会影响普通用户正常访问网站?不会,就合规;可能会,立刻停。
轻量目录扫描属于信息收集范畴,只要控制好速率,完全在合规范围内。
三、为什么你做得慢?核心误区
你觉得慢、不敢放开扫,本质不是 “扫描速度慢”,而是策略错了:
- 误区 1:字典越大越好。实际上几万条的大字典,90% 都是无效请求,既慢又容易触发 WAF 封 IP,反而什么都扫不到。
- 误区 2:上来就主动扫。被动收集零风险、不碰服务器,还能挖出大量隐藏路径,效率远高于瞎扫。
- 误区 3:越快越好。开高并发看似快,实则触发风控就被封 IP,直接全军覆没;慢而稳地跑完精简字典,命中率反而高得多。
公益 SRC 的绝大多数站点,后台、备份、敏感路径基本都在最常见的 300~500 条里,精简字典 + 低速 + 被动优先,才是规则内的最高效率。
四、规则内最高效的信息收集方案(新手直接照做)
按优先级三步走,既能保证合规,又能把效率拉满。
第一步:被动收集(零风险,占 60% 工作量)
全程几乎不发请求,完全不会被判定骚扰,却能挖出 70% 以上的隐藏路径。
- 子域资产收拢:用 subfinder、OneForAll 或在线平台(微步、Fofa)查子域,先把授权范围内的资产列清楚,不要对着根域名瞎扫。
- 历史路径回溯:用 Wayback Machine、archive.org 查这个站点历史上出现过的 URL,很多废弃的后台、老接口都能挖到。
- JS 文件扒接口:爬取网站前端 JS,提取里面的 API 路径、后台地址。这是目前最高效的找后台方式 —— 很多开发会把管理端路径直接写在 JS 里,主动扫描反而扫不到。
这一步做完,你已经有了一批目标路径,根本不需要全量字典瞎跑。
第二步:轻量主动扫描(精准打击,占 30% 工作量)
只针对根目录和关键子目录,用精简字典、低速扫描。
字典必须精简:不要用几万条的大字典,就用 300~500 条的「常见后台 + 备份文件 + 敏感文件」精简字典。公益 SRC 80% 能挖到的路径都在这里面。
速率必须控死(核心)
:
- 并发数:1~2 个,绝对不要开多
- 请求间隔:1000
2000 ms(12 秒一个请求) - 这个速率对任何网站都不会造成负载影响,也基本不会触发 WAF 限流
不做递归深扫:只扫根目录和几个核心子目录,不要全站层层递归,太费时间且收益极低。
第三步:手动验证 + 深入测试(占 10% 工作量)
- 扫到疑似路径,手动访问验证状态码和页面内容,确认有效再深入。
- 找到入口后,针对性测越权、逻辑漏洞,不要批量跑 payload。
五、对应你正在用的 Burp 内容发现:具体限速设置
就在你当前的内容发现窗口里调,按下面的数值设,绝对合规:
切换到 Config 标签页,找到 Resource pool(资源池)设置
新建一个资源池,命名比如「低速合规」
参数设置:
- 勾选 Maximum concurrent requests,填
1(最多 1 个并发) - 勾选 Delay between requests,填
1000(1 秒间隔) - 可选:勾选 Add random variations,加随机波动,模拟真人访问,更不容易被风控
- 勾选 Maximum concurrent requests,填
把当前内容发现任务分配到这个资源池
额外建议:在扫描选项里,取消不必要的文件类型扫描,只扫常见目录和脚本文件,不要扫图片、CSS 这类静态资源,能省大量时间
新手避坑最后提醒
- 先看规则再动手:每个 SRC 规则不一样,比如有的厂商明确禁止自动化扫描工具,那就只能被动收集 + 手动测试。大部分公益 SRC 允许轻量扫描,但先看公告不吃亏。
- 遇到 429/503 立刻停:这是服务器的限流警告,再加量就可能被封 IP、被判定骚扰。立刻降速或者暂停。
- 避开业务高峰:尽量不在白天用户多的时候扫,凌晨测试更稳妥,也不容易触发风控。
- 宁慢勿快:慢一点,能完整扫完字典,总能找到东西;开快了被封 IP,直接全军覆没。这是新手最容易踩的坑。